
ki
Zero Data Retention: KI in der Cloud nutzen, ohne Daten preiszugeben
Frontier-Modelle laufen nur in der Cloud – heißt das, Sie müssen Geschäftsgeheimnisse an einen Anbieter übergeben? Zero Data Retention ist die Lösung. Der Artikel erklärt die Technologie, vergleicht die Richtlinien von Ollama Cloud, OpenAI, Gemini und Anthropic mit deren eigener Dokumentation, zeigt die Risiken, die ZDR nicht abdeckt, und liefert einen nachprüfbaren Due-Diligence-Plan für Unternehmen.
KI-Entwurf · geprüft und bearbeitetDieser Text wurde mit KI als Erstentwurf erstellt und anschließend von der Autorin bzw. dem Autor geprüft und bearbeitet, die bzw. der die redaktionelle Verantwortung dafür trägt.
Zero Data Retention: KI in der Cloud nutzen, ohne Daten preiszugeben
Der Ausgangspunkt ist ein Dilemma, das jedes Unternehmen 2026 kennt. Die leistungsfähigsten Modelle — Kimi K3 mit 2,81 Billionen Parametern, DeepSeek V4-Pro mit 1,65 Billionen — laufen ausschließlich auf Rechenzentrums-GPUs. Wer sie nutzen will, schickt seine Prompts übers Netz. Und genau in diesem Moment stellt sich die Frage, die über Erfolg und Rechtmäßigkeit des gesamten KI-Deployments entscheidet: Was passiert mit meinen Daten, nachdem die Antwort zurückkommt?
Die Antwort der Branche heißt Zero Data Retention (ZDR) — und sie ist so wichtig wie missverstanden. Manche halten sie für eine Marketingfloskel, andere für eine Garantie, die rechtlich gar nicht möglich ist. Beide liegen falsch. Dieser Artikel seziert, was ZDR technisch bedeutet, wie der Datenfluss tatsächlich aussieht, welche Risiken ZDR nicht löst — und wie ein Unternehmen überprüfbar feststellt, ob ein Anbieter sein Versprechen hält. Am Ende: ein Vergleich der großen Anbieter anhand ihrer eigenen Dokumentation — und warum Ollama Cloud darin eine Sonderstellung einnimmt.
Was Zero Data Retention bedeutet — und was nicht
Zero Data Retention ist eine vertragliche und technische Zusage: Der Anbieter speichert Kundendaten nicht dauerhaft. Prompts und Antworten werden nur so lange vorgehalten, wie es die Anfrage technisch erfordert — im Arbeitsspeicher, während das Modell den Token-Stream generiert. Dann wird der Speicher freigegeben. Nichts landet in einer Datenbank, nichts in einem Trainingskorpus, nichts in einem Archiv.
Die Abgrenzung zu zwei schwächeren Stufen ist entscheidend, denn ZDR wird ständig mit ihnen verwechselt:
- Stufe 1 — kein Training: die schwächste Zusicherung. Ihre Daten können trotzdem bis zu 30 Tage in Missbrauchs-Überwachungslogs verbleiben — sie werden nur nicht zum Training des Modells genutzt. Löschung ist nicht inbegriffen.
- Stufe 2 — keine menschliche Einsicht: automatisierte Speicherung bleibt erlaubt, nur Menschen lesen nicht mit. Für Geschäftsgeheimnisse macht das einen relevanten Unterschied.
- Stufe 3 — Zero Data Retention: keine dauerhafte Speicherung von Prompts und Antworten, kein Trainingseinsatz — das Zeitfenster, in dem Ihre Daten überhaupt existieren, schrumpft auf die Dauer der Anfrage selbst.
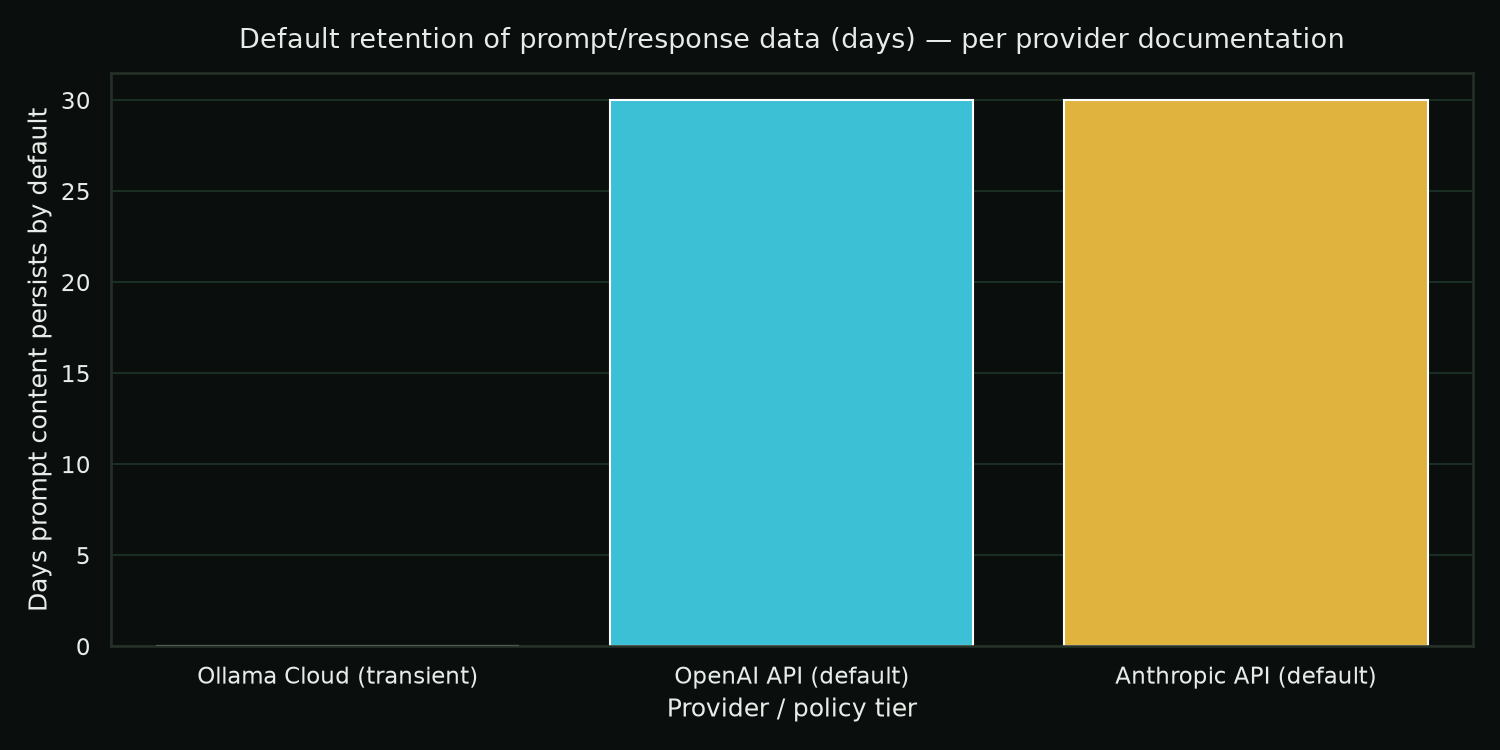
Diese Stufen sind keine Theorie — sie finden sich wortwörtlich in den Dokumentationen der Anbieter. OpenAI speichert API-Daten standardmäßig für up to 30 days zur Missbrauchsüberwachung; ZDR ist nur auf Anfrage, nach Aktivierung und ausschließlich für gelistete Endpunkte verfügbar. Google protokolliert Prompt- und Antwortdaten der kostenpflichtigen Gemini-API „für eine begrenzte Zeit“ ausschließlich zur Durchsetzung seiner Nutzungsrichtlinien. Anthropic löscht API-Daten standardmäßig „innerhalb von 30 Tagen“ und bietet ZDR als separaten Vertrag an, der pro Organisation aktiviert werden muss. Fazit: Fast jeder große Anbieter verlangt, dass Sie aktiv nach ZDR fragen — bei Ollama Cloud ist es die dokumentierte Voreinstellung für jede Anfrage.
Technische Funktionsweise: der Lebenszyklus einer Anfrage
Um zu verstehen, warum Zero Data Retention (ZDR) überhaupt glaubwürdig ist, müssen Sie sehen, was technisch während einer Cloud-Inferenz passiert. Die Grafik zeigt den Lebenszyklus eines Prompts — und den genauen Punkt, an dem sich die Richtlinien unterscheiden:

Drei technische Eigenschaften machen Zero Retention überhaupt erst möglich:
- Zustandslose Inferenz: Sprachmodelle haben kein Gedächtnis. Jede Anfrage ist in sich abgeschlossen; das Modell „erinnert“ sich an keine vorherigen Anfragen. Es gibt keinen technischen Grund, Prompt-Daten zu speichern — die Speicherung ist eine Richtlinienentscheidung, keine technische Notwendigkeit.
- Flüchtige Verarbeitung im VRAM: während der Generierung existieren die Prompt-Tokens als Aktivierungen im GPU-Speicher und werden mit jedem Schritt überschrieben. Nach der Antwort wird der Kontext verworfen. Kein Schreiben auf die Festplatte, keine dauerhafte Verknüpfung mit Ihrem Konto.
- Kein Training, keine Protokollierung: die Antwort geht direkt zurück an den Client. Bei ZDR wird kein Missbrauchsprotokoll mit Prompt-Inhalten geschrieben, kein Feedback-Speicher gefüllt, kein Trainingskorpus angereichert.
OpenAI dokumentiert eine harte technische Konsequenz für ZDR-Kunden: der store Parameter von Chat Completions und Responses wird zwingend als false — die API verweigert schlicht die Persistenz Ihrer Daten, selbst wenn die Anfrage sie anfordert. Das ist der Unterschied zwischen einem Versprechen und einer Architektur, die es nicht zulässt. Harte Garantien wie diese sind genau das, worauf ein Due-Diligence-Prozess prüfen sollte.
Warum Frontier-Modelle ohnehin nur in der Cloud laufen
Ein Einwand bleibt: Wenn lokale KI so datensicher ist, warum überhaupt in die Cloud gehen? Die Antwort liegt in der Physik, nicht im Komfort. Die Grafik zeigt die Dimension der aktuellen Modellgeneration:
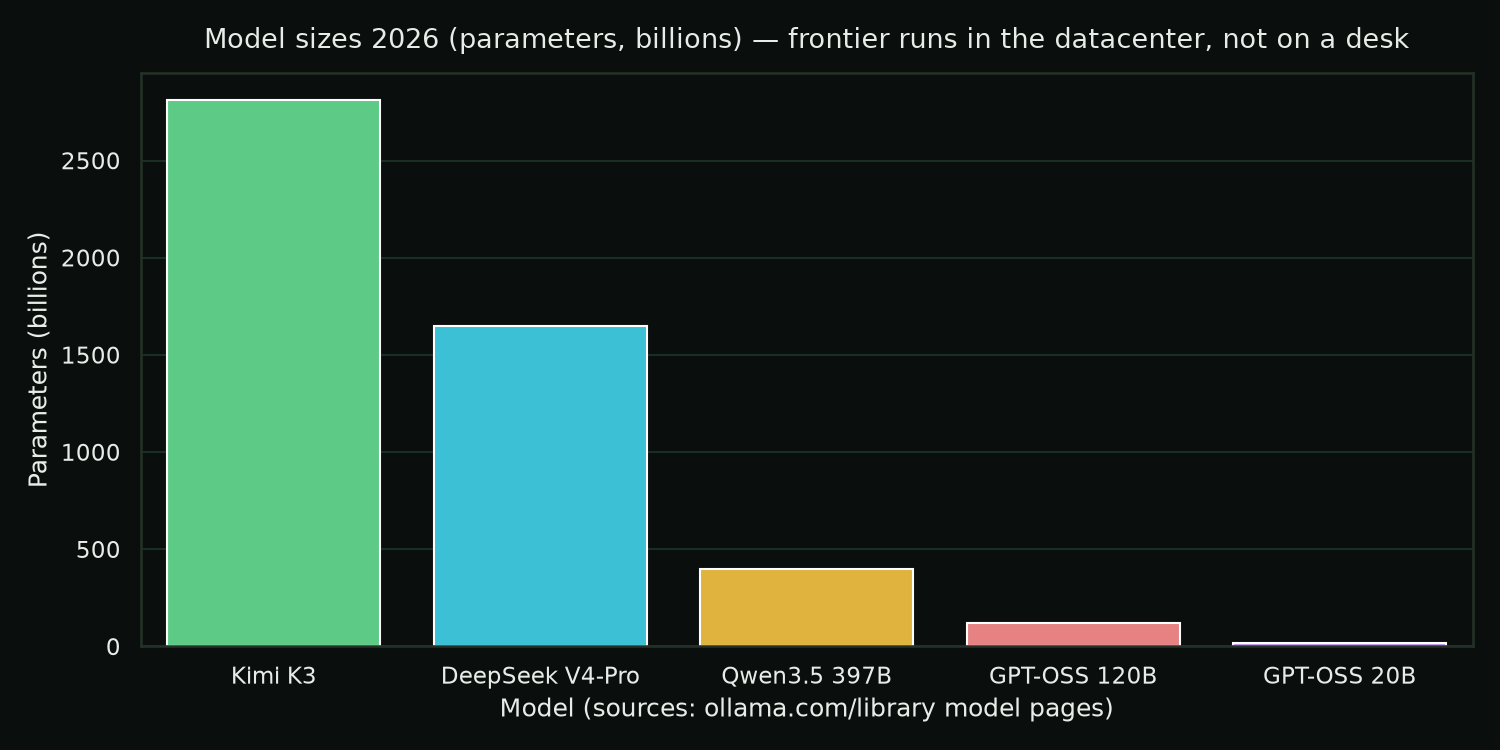
Kimi K3 mit 2,81 Billionen Parametern (MoE, 16 von 896 Experten aktiv, 1 Million Token Kontext) passt kategorisch nicht in den VRAM einer Workstation — selbst High-End-Hardware mit 16, 24 oder 48 GB scheitert bereits an der schieren Modellgröße, bevor ein einziger Token generiert wird. Frontier-Inferenz ist eine Rechenzentrumsangelegenheit. Die strategische Frage lautet daher nicht „Cloud oder lokal?“, sondern „Cloud — unter welchen Retentionsbedingungen?“
Hier schließt sich der Kreis zurück zur lokalen Welt: Für die Modellklasse bis ~14B Parameter bleibt lokale Inferenz die datensicherste Option, die es gibt — die Daten verlassen den Standort nie. Ollama deckt beide Welten mit derselben Oberfläche ab: ollama run llama3.2:8b läuft lokal, ollama run kimi-k3:cloud geht in die Cloud. Die Referenzarchitektur:

Die Risiken, die Zero Retention nicht löst
Wer ZDR als „100 % Datensicherheit“ verkauft, gibt eine falsche Zusicherung ab — diese klare Warnung gehört in jeden Beschaffungsprozess. ZDR behandelt ausschließlich die Persistenz von Inhalten nach der Verarbeitung. Diese Risikobereiche bleiben vollständig bestehen:
- Übertragungsrisiko: der Prompt verlässt Ihr Netzwerk. TLS schützt die Übertragung, doch sobald die Daten Ihre Kontrollsphäre verlassen, geht die Kontrolle an den Anbieter über — inklusive dessen Rechtssystem. Ollama verarbeitet Cloud-Daten primär in den USA, mit Routing nach Europa und Singapur bei Kapazitätsspitzen; der US CLOUD Act gilt dort unabhängig von irgendwelchen Richtlinien. ZDR schützt nicht vor staatlichem Zugriff während der Verarbeitung.
- Metadaten: selbst bei ZDR werden Kontodaten, Anfragezähler, App-Versionen, IPs und Zeitstempel erfasst. Ollama sammelt explizit „begrenzte Geräte- und Nutzungsmetadaten, die keine Prompt- oder Antwortinhalte umfassen“. Metadaten allein können Nutzungsmuster und betriebliche Geheimnisse offenlegen.
- Missbrauchsklauseln: fast jede Richtlinie enthält Vorbehalte für markierte Inhalte, Sicherheitsaufbewahrung und rechtliche Sperren — Anthropic behält sich beispielsweise bis zu 2 Jahre Speicherung für Inhalte vor, die seine automatisierten Systeme als richtlinienwidrig kennzeichnen. ZDR gilt immer „vorbehaltlich gesetzlicher Anforderungen“ — eine Ausnahme, die Sie kennen sollten, aber nicht wegverhandeln können.
- Lieferkette: Cloud-KI ist eine Kette. Ollama Cloud leitet über NVIDIA Cloud Providers (NCPs), Zahlungen laufen über Stripe, die Infrastruktur steht bei Cloud-Hosts. Jedes Glied muss den Zero-Retention-Anspruch vertraglich übernommen haben — das schwächste Glied bestimmt das Gesamtrisiko.
- Menschen und Organisation: ein Mitarbeiter, der vorsätzlich vertrauliche Daten in einen Prompt einfügt, umgeht jede Richtlinie — Schatten-KI ist 2026 ein Top-Risiko, kein Einzelfall. Der Verizon DBIR 2026 zeigt das Ausmaß der allgemeinen Bedrohungslage: 48 % aller Vorfälle betreffen Ransomware, 31 % beginnen mit ausgenutzten Software-Schwachstellen, und 15 % der Angriffstechniken werden mittlerweile durch generative KI verstärkt. Keine Aufbewahrungsrichtlinie der Welt hilft, wenn die Organisation selbst das schwächste Glied ist.
Zero Retention macht aus der Cloud-KI einen transienten Durchlauf — nicht zu einem Datentresor und nicht zu einer Risikoblase. Wer die verbleibenden Risiken kennt, kann sie steuern; wer sie leugnet, wird von ihnen gesteuert.
Sicher betreiben: die Regeln, die in der Praxis halten
Fünf Betriebsregeln ergeben sich aus dem Risikobild — alle in der Praxis erprobt:
- Daten vor der Tool-Auswahl klassifizieren. Rot (personenbezogene Daten, Geschäftsgeheimnisse, regulatorische Daten), gelb (interne, nutzbare anonymisierte Daten), grün (öffentlich). Für rote Daten gilt: lokal oder gar nicht; alles andere darf unter ZDR-Bedingungen in die Cloud.
- Zentraler Gateway-Zugriff. Alle KI-Aufrufe laufen über eine verwaltete Instanz, die Metadaten protokolliert (wer, wann, welches Modell — niemals Prompt-Inhalte), Schlüssel verwaltet und DLP-Filter anwendet. Das beseitigt Schatten-IT und verwandelt die Metadatenlücke in einen Audit-Pfad.
- Vertragliche Absicherungen. Ein Auftragsverarbeitungsvertrag nach Art. 28 GDPR, ein schriftlicher ZDR-Zusatz, der „Kundeninhalte“ definiert, eine Liste der Unterauftragsverarbeiter mit Meldepflicht bei Änderungen und eine Löschbestätigung als Vertragsbestandteil.
- Prompt-Hygiene trainieren. Keine Kunden-IDs, keine Namen, keine Geheimnisse im Prompt, es sei denn, die Aufgabe erfordert es. Pseudonymisierung bleibt der stärkste Hebel — sie reduziert das Risiko vor der Übertragung.
- Die hybride Architektur ernst nehmen. Nicht alles braucht Frontier. Bis zu ~14B Parametern läuft die Inferenz lokal ohne Datenübertragung; die Cloud (mit ZDR) ist die Ausnahme für lange Kontexte und schwere Aufgaben — nicht die Standardeinstellung.
Überprüfen, nicht vertrauen: der Due-Diligence-Plan für Unternehmen
Die zentrale Beschaffungsfrage lautet: Wie lässt sich feststellen, dass ein Anbieter Zero Retention tatsächlich einhält? Die ehrliche Antwort zuerst: ein absoluter, mathematischer Beweis von außen ist unmöglich. Was möglich ist — und was professionelle Einkäufer von Cloud-Diensten seit Jahren praktizieren — ist die Kombination aus Vertrag, Architekturnachweisen, Audit und technischen Stichproben. Diese vier Ebenen ergeben ein prüfbares und vertretbares Risiko. Der Ablauf:

Ebene 1 — Dokumente und Vertrag. Die Retention-Richtlinie gehört in die Datenverarbeitungsvereinbarung, nicht nur ins Blog. Verlangen Sie: eine schriftliche ZDR-Nachträge, die Subunternehmerliste (wer überhaupt Daten sieht), Löschfristen pro Datenkategorie und Meldepflichten bei Richtlinienänderungen. OpenAI und Anthropic ermöglichen ZDR ausschließlich über Vertrag und organisationsweite Freischaltung — ein Anbieter, der das verweigert, hat seine Antwort gegeben.
Ebene 2 — Architekturnachweise. Fordern Sie technische Details: Wird Prompt-Inhalt in Anwendungszustände geschrieben (Files API, Threads, Sitzungsspeicher, Verlauf)? Unter ZDR muss die Antwort „nein“ lauten, oder diese Funktionen müssen gesperrt sein — genau wie OpenAI es für seine ZDR-Endpunkte dokumentiert. Betrachten Sie jeden Anbieter mit Misstrauen, der ZDR verspricht, aber zustandsbehaftete Funktionen mit serverseitigem Verlauf aktiv lässt.
Stufe 3 — unabhängige Audits. SOC 2 Type II, ISO/IEC 27001, ISO/IEC 42001 (KI-Management) und für den deutschen öffentlichen Sektor BSI C5 sind die üblichen Zertifizierungen. Sie beweisen nicht die einzelne Löschung, aber sie prüfen, ob die behaupteten Prozesse existieren und laufen. Ein Anbieter ohne aktuelle Audits und mit rein marketingsprachlichen Zusicherungen scheitert an Stufe 3.
Stufe 4 — technische Stichproben im Betrieb. Kanarientests mit eindeutig markierten, aber fiktiven sensiblen Daten (z. B. erfundene Kundennummern mit Wasserzeichen), Supportanfragen zu „verlorenen“ Prompts (ein seriöser Anbieter kann sie nicht wiederherstellen — und muss das auch so kommunizieren), Prüfung der vom Anbieter exportierbaren Logs, jährliche Nachauditierung der Richtlinienversionen. Das ist keine 100%ige Sicherheit — aber es ist die einzige Kombination, die ein GDPR-relevantes Vertrauensproblem in ein dokumentiertes Restrisiko verwandelt.
Wer „100% Datensicherheit“ in eine Anforderung schreibt, bekommt von jeder Rechtsabteilung seriöser Unternehmen dieselbe Antwort: Sie existiert nicht — weder lokal (ein kompromittierter Laptop ist ein vollwertiges Datenleck) noch in der Cloud. Realistisch und erreichbar ist ein Zustand, in dem kein Persistenzpfad für Prompt-Inhalte beim Anbieter existiert, vertraglich zugesichert, architektonisch erzwungen und durch Audits überprüfbar. Genau das liefert der oben beschriebene Prozess — und genau dieser Standard sollte als Maßstab für Anbieter gelten.
Anbietervergleich: Wer dokumentiert Retention wie
Alle Aussagen folgen den verlinkten Primärquellen der Anbieter (Stand September 2026 — Richtlinien ändern sich, prüfen Sie vor jedem Vertrag die aktuelle Fassung):
- Ollama Cloud – Cloud-Modelle werden „transient“ verarbeitet, Inhalte „werden nicht länger gespeichert als für die Bearbeitung der Anfrage nötig“; „Prompt- oder Antwortdaten werden niemals protokolliert oder zum Training verwendet“; Partner (NVIDIA Cloud Providers) sind vertraglich verpflichtet, „keine Protokollierung, kein Training und Zero-Data-Retention-Richtlinien“ einzuhalten. Kein Antrag, keine Freischaltung – die Richtlinie gilt für jede Cloud-Anfrage, dokumentiert in der Datenschutzerklärung und den Preisfragen. Lokale Ollama-Nutzung bleibt vollständig datenfrei: Das Programm sieht niemals, dass Ihre Prompts den Rechner verlassen.
- OpenAI API – Standard: bis zu 30 Tage Aufbewahrung zur Missbrauchskontrolle, kein Training ohne Opt-in. ZDR existiert, erfordert aber Antrag und Freischaltung und gilt nur für gelistete Endpunkte; der Parameter *store* wird unter ZDR auf *false* gesetzt.
- Google Gemini API (kostenpflichtig) – Kostenpflichtige Stufe: Prompts und Antworten werden nicht zur Produktverbesserung genutzt, aber „für begrenzte Zeit“ protokolliert – ausschließlich zur Durchsetzung der *Prohibited Use Policy*. ZDR im engeren Sinn ist nicht Teil des Angebots; der Schutz lautet „kein Training, begrenzte Protokollierung für Richtlinien“.
- Anthropic API – Standard: automatische Löschung von Ein- und Ausgaben „innerhalb von 30 Tagen“, kein Training ohne Erlaubnis. ZDR als separater Vertrag pro Organisation („Anthropic speichert Kunden-Prompts oder -Antworten nicht dauerhaft nach Rückgabe der API-Antwort“); Ausnahmen für *Covered Models*, *Console* und markierte Inhalte.
- Azure OpenAI (Microsoft Foundry) – Modelle sind zustandslos; Prompts/Completions werden nicht zum Training genutzt und nicht an OpenAI weitergegeben. Missbrauchskontrolle lässt sich auf Anfrage einschränken; *Customer-Managed Keys* und EU-Verarbeitung sind verfügbar. Das stärkste Enterprise-Paket – doch auch hier bedeutet ZDR „Kontrolle auf Anfrage begrenzt“, nicht standardmäßig.
Der strukturelle Unterschied: Bei OpenAI, Google, Anthropic und Azure ist ZDR (oder eine Annäherung daran) eine verhandelte Angelegenheit mit Ausnahmen — bei Ollama Cloud ist es der dokumentierte Produktstandard. Dazu kommt die vollständig lokale Grundlage: gleiche CLI, gleiche API, und bei sensiblen Workloads bleibt alles auf der eigenen Maschine. Für Teams, die beide Welten brauchen, ist das ein ungewöhnlich klarer Ausgangspunkt.
Was kostet die Cloud-Option konkret? Die Ollama-Modellpreise (Basis-Fenster, pro 1 Mio. Ausgabe-Tokens) decken diese Spanne ab:
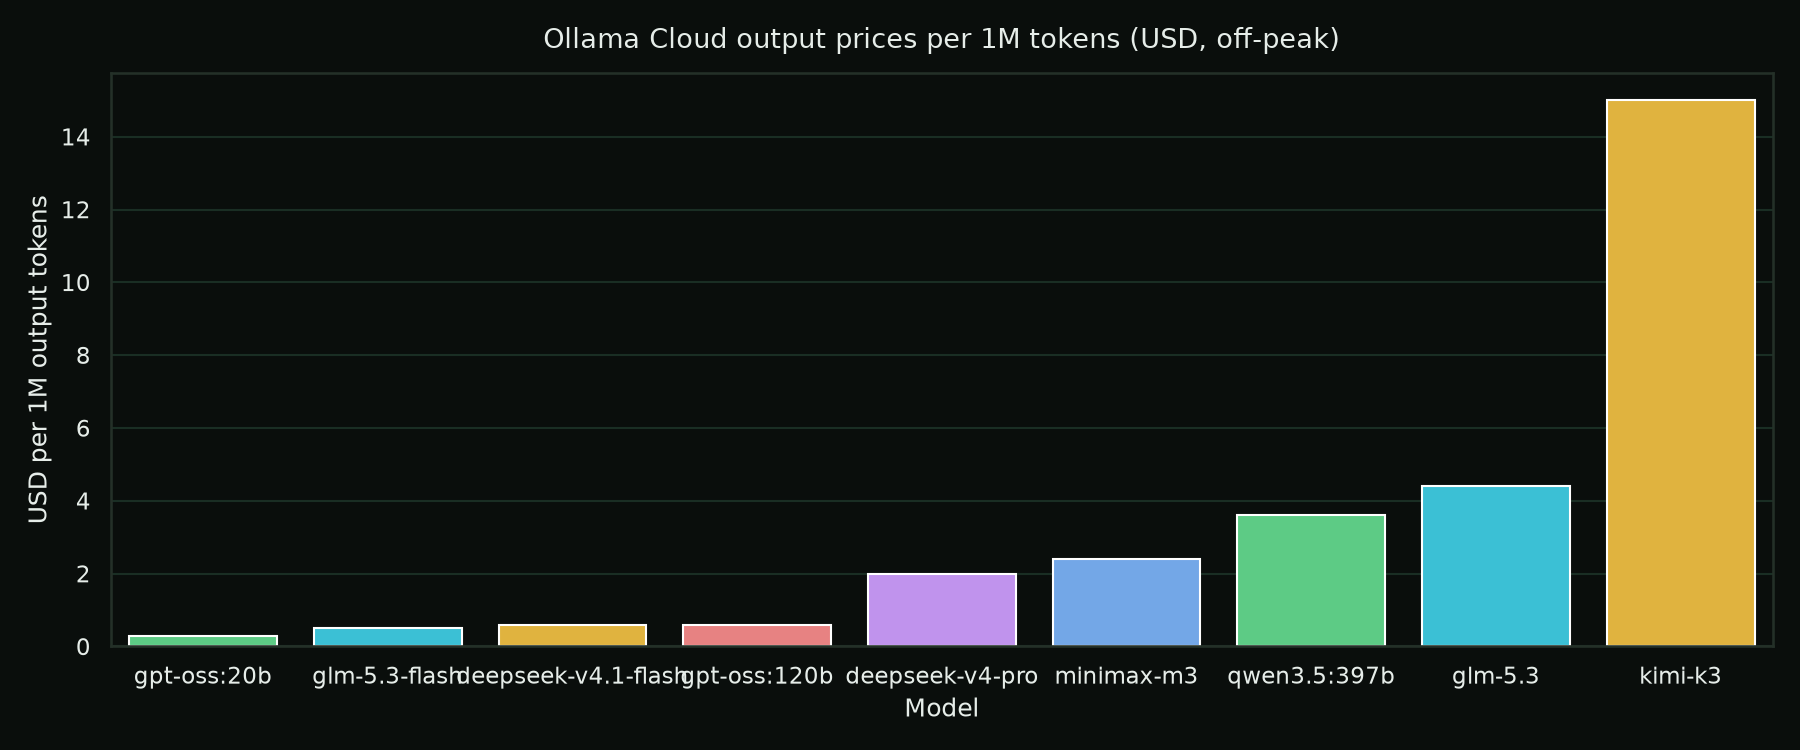
Die Preisstruktur ist einfach: Ein Free-Plan mit Startguthaben, Pro für $20/month mit 60 $ Nutzungsguthaben, Max für $100/month mit 300 $ Guthaben und 10 gleichzeitigen Anfragen, Team für $500/month mit einem gemeinsamen Guthaben von 1.000 $. Keine Servicegebühren auf Token-Preise, lokale Nutzung unbegrenzt. Für ein Pilotprojekt liegt der Einstieg unter einem typischen SaaS-Budget — und die Speicherrichtlinie hängt nicht vom Tarif ab.
Der rechtliche Rahmen: DSGVO (GDPR), AI Act und die Grenzen von Verträgen
Für europäische Unternehmen ist ZDR kein Nice-to-have — sie ist oft die Voraussetzung für die DSGVO-konforme Nutzung und wird durch den EU AI Act [legal_ref] weiter verschärft: Art. 5 Abs. 1 lit. c und e GDPR verlangen Datenminimierung und Speicherbegrenzung — ein Anbieter, der Prompts 30 Tage lang speichert, braucht dafür eine Rechtsgrundlage und muss sie im Abwägungstest verteidigen. Bei der Verarbeitung im Auftrag eines Verantwortlichen ist ein Auftragsverarbeitungsvertrag nach Art. 28 GDPR zwingend; bei US-Anbietern kommen Standardvertragsklauseln (SCC) für die Übermittlung hinzu. Der EU AI Act legt darüber hinaus Transparenz- und Risikopflichten auf, je nach Anwendungsfall. Die nüchterne Lesart: Zero Retention ist der kürzeste Weg zu „Speicherbegrenzung erfüllt“ — ersetzt aber weder eine Rechtsgrundlage noch eine Risikoprüfung noch einen Auftragsverarbeitungsvertrag.
Trend: Retention wird zum Beschaffungskriterium
Drei Entwicklungen verstärken sich gegenseitig. Erstens: Frontier-Modelle werden größer, nicht kleiner — die lokale Abdeckung bleibt auf die 14B-Klasse begrenzt, und der Cloud-Anteil an Unternehmens-KI wächst. Zweitens: Die Regulierung wird strenger — der EU AI Act und steigende Dokumentations- und Prüfpflichten machen „Vertrauen in den Anbieter“ zum Haftungsrisiko. Drittens: Die Anbieter selbst entdecken Retention als Wettbewerbsvorteil — Ollama vermarktet Zero Retention als Verkaufsargument, Azure baut CMK und EU-Verarbeitung aus, OpenAI wirbt mit ZDR für Frontier-Modelle. Die Richtung ist klar: wer 2026 Cloud-KI beschafft, verhandelt Retention-Bedingungen — nicht Features.
Das Fazit: nachweisbares Vertrauen statt blindem Glauben
Zero Data Retention ist kein Marketingwort mehr — es ist eine überprüfbare Produkt- und Vertragsposition mit echter Technik dahinter. Und es ist keine Garantie: Restrisiken durch Übertragung, Metadaten, Missbrauchsklauseln und die Lieferkette bleiben bestehen. Die richtige Haltung ist daher nüchtern:
- Klassifizieren Sie Ihre Daten — rote Daten bleiben lokal; alles andere darf unter ZDR in die Cloud.
- Lesen Sie die Richtliniendokumente der Anbieter — und lassen Sie die Speicherklausel in den Vertrag aufnehmen, nicht nur auf der Marketingseite.
- Fordern Sie Audits und architektonische Nachweise (SOC 2, ISO 27001/42001, BSI C5; *store=false*-Durchsetzung, kein Anwendungsstatus für Inhalte).
- Überprüfen Sie mit Kanariendaten und Log-Exporten — und wiederholen Sie dies jährlich.
- Denken Sie hybrid: lokal, wo es ausreicht; Cloud mit ZDR, wo Frontier-Leistung nötig ist. Genau dafür ist Ollama Cloud gemacht — lokale KI und eine Zero-Retention-Cloud unter einer Oberfläche, kein Training mit Ihren Daten, keine Inhaltsprotokollierung, und dieselben Anforderungen an Partner.
Niemand verspricht ernsthaft 100 % Datensicherheit. Was versprochen und überprüft werden kann: Es gibt keinen Weg, auf dem Ihre Prompts zu Datenassets beim Anbieter werden.
Quellen
- Ollama-Datenschutzrichtlinie („processed transiently“, „not stored beyond the time required“, „never train on it“) —
https://ollama.com/privacy - Ollama-Preise (Modellpreise, „Prompt or response data is never logged or trained on“, NCP-ZDR-Anforderung, Hosting USA/Europa/Singapur) —
https://ollama.com/pricing - Ollama-Modellseiten: Kimi K3 (2,81 T Parameter, 1 Mio. Kontext) —
https://ollama.com/library/kimi-k3· DeepSeek V4-Pro (1,65 T) —https://ollama.com/library/deepseek-v4-pro - OpenAI: Datenkontrollen / Zero Data Retention (30-Tage-Standard, ZDR-Endpunkte, store=false) —
https://developers.openai.com/api/docs/guides/your-data· ZDR für Frontier-Modelle – Ankündigung —https://openai.com/index/offering-zero-data-retention-for-frontier-models/ - Google: Gemini API Additional Terms – Paid Services („doesn’t use your prompts ... to improve our products“, begrenzte Protokollierung für Richtliniendurchsetzung) —
https://ai.google.dev/gemini-api/terms - Anthropic: API und Datenspeicherung (ZDR-Umfang, Covered Models, markierte Inhalte 2 Jahre) —
https://platform.claude.com/docs/en/manage-claude/api-and-data-retention· Organisationsspeicherung (30-Tage-Standard) —https://privacy.claude.com/en/articles/7996866-how-long-do-you-store-my-organization-s-data - Microsoft: Daten, Datenschutz und Sicherheit für über Azure verkaufte Modelle (stateless, kein Training, CMK, Missbrauchsüberwachung auf Anfrage ausgenommen) —
https://learn.microsoft.com/en-us/azure/foundry/responsible-ai/openai/data-privacy - Verizon DBIR 2026 (48 % Ransomware, 31 % Exploits, 15 % KI-verstärkte Techniken) —
https://www.verizon.com/business/resources/reports/dbir/ - EU-DSGVO (GDPR): Art. 5 (Datenminimierung, Speicherbegrenzung), Art. 28 (Verarbeitung im Auftrag) —
https://gdpr-info.eu/
weiterlesen

Die KI, die nicht sprechen wollte: System One lokal auf der eigenen Maschine
Ein Support-Ticket, drei Entscheidungsmodelle, keine Grafikkarte: Ich habe die System-One-Modelle mit 144M, 421M und 4,2B Parametern auf meiner eigenen CPU laufen lassen und aufgeschrieben, was jedes einzelne gesagt hat. Das 144M-Modell verpasste den Satz „I am cancelling on Friday“; das vage Ticket produzierte drei unterschiedliche Antworten. Was ein Entscheidungsmodell ist, wie man es mit llama.cpp oder Ollama betreibt und wie sich Kev, Nimble, Laya und Jev vergleichen.
ki · 19 min · 2026-10-14
Mistral Large 4: Das Cybersicherheitsmodell, das sich weigert, abzulehnen
Sechs Frontier-Modelle lehnen ≥98 % der realen CVE-Reproduktions- und Patch-Aufgaben ab. Mistral Large 4 erledigt sie – und liegt in 82 % der Fälle richtig, der höchste je gemessene Wert. Diagramme, unabhängige Ausfalldaten und die ehrliche Anatomie dessen, was ein Verteidigungsmodell kann und was nicht.
ki · 18 min · 2026-10-07
Wie man KI-Expert:in wird: der Weg, der tatsächlich eine hervorbringt
Anthropics eigene Stellenausschreibungen sagen es unverblümt: formale Zertifizierungen sind ausdrücklich optional, und die entscheidende Frage im Auswahlverfahren lautet, ob Sie bereits ein LLM-System für echte Nutzer:innen in Produktion gebracht haben. Der vollständige Weg: wofür der Markt tatsächlich einstellt, der siebenstufige Builder-Stack, die Lernforschung dazu, warum Zuschauen scheitert, die ehrlichen Misserfolgszahlen — und eine Build-Leiter, um diesen Monat zu starten.
ki · 21 min · 2026-10-05