
ki
Mistral Large 4: Das Cybersicherheitsmodell, das sich weigert, abzulehnen
Sechs Frontier-Modelle lehnen ≥98 % der realen CVE-Reproduktions- und Patch-Aufgaben ab. Mistral Large 4 erledigt sie – und liegt in 82 % der Fälle richtig, der höchste je gemessene Wert. Diagramme, unabhängige Ausfalldaten und die ehrliche Anatomie dessen, was ein Verteidigungsmodell kann und was nicht.
KI-Entwurf · geprüft und bearbeitetDieser Text wurde mit KI als Erstentwurf erstellt und anschließend von der Autorin bzw. dem Autor geprüft und bearbeitet, die bzw. der die redaktionelle Verantwortung dafür trägt.
Mistral Large 4: Das Cybersicherheitsmodell, das sich weigert, abzulehnen
Kategorie: KI · Cybersicherheit Autor: Mohammed Kmail Lesezeit: ~18 Minuten
Es gibt einen Moment im Leben jedes Sicherheitsteams, für den keine Produktdemo vorbereitet. Sie haben eine echte Schwachstelle in Produktionssoftware gefunden. Sie brauchen ein Modell, um sie zu reproduzieren, zu bestätigen und beim Schreiben des Patches zu helfen. Sie fügen die Details in Claude ein. Es lehnt ab. Sie versuchen es mit GPT-6. Wieder abgelehnt. Die beiden leistungsfähigsten Modelle auf dem Markt weigern sich, genau die Aufgabe anzugehen, die Ihre Infrastruktur schützt — weil ihre Sicherheitsfilter nicht zwischen Verteidiger und Angreifer unterscheiden können.
Geben Sie dieselbe Aufgabe nun in Mistral Large 4ein. Es reproduziert die Schwachstelle, bestätigt sie und hilft Ihnen beim Patchen — mit 82 % im Reproduktions- und Patch-Test, der höchste Wert aller getesteten Modelle, einschließlich der geschlossenen. Diese eine Zahl erzählt die ganze Geschichte, warum Europa dieses Modell gebaut hat und warum es für jeden relevant ist, der Sicherheitsoperationen durchführt.
Die Verteidigung von Software beginnt oft damit, zu beweisen, dass eine Schwachstelle real ist. Genau diese Arbeit blockieren die Sicherheitsfilter geschlossener Modelle — während Angreifer dieselben Modelle jailbreaken, um das Gegenteil zu tun.
Das Modell: eine Billion Parameter, europäisch by design
Am 6. Oktober 2026 veröffentlichte Mistral AI die öffentliche Vorschau von Mistral Large 4 — interner Codename „le Chonk“, französisch für „der Brocken“. Der Name ist das Verkaufsargument: Dies ist das größte Modell, das Mistral je ausgeliefert hat, und es ist ungeniert schwer.
Die Architektur ist ein sparsames Mixture-of-Experts (MoE): 1,05 Billionen Parameter insgesamt, von denen nur 49 Milliarden pro Token aktiv sind. Das Modell ist nativ multimodal (Text- + Bildeingabe, mit einem 1,6-Milliarden-Parameter-Vision-Encoder), deckt ein 1-Million-Token-Kontextfensterab und spricht mehr als 160 Sprachen, darunter alle offiziellen EU-Sprachen. Es wurde von Grund auf auf 3.800 NVIDIA Grace Blackwell GPUs in Mistrals eigenen europäischen Rechenzentren trainiert.
Specification            | Value
-------------------------|------------------------------------------
Total parameters         | 1.05 trillion
Active parameters/token  | 49 billion
Vision encoder           | 1.6 billion parameters
Context window           | 1,000,000 tokens
Modalities               | Text + image (native multimodal)
Languages                | 160+ (incl. all EU official languages)
Training hardware        | 3,800 × NVIDIA Grace Blackwell
Training location        | Mistral EU data centers (from scratch)
API price (input)        | $1.36 / 1M tokens (list price, Mistral.ai)
API price (output)       | $4.18 / 1M tokens
Weights release          | October 27, 2026 (Mistral: “end of October”)
Das MoE-Design macht ein Billionen-Parameter-Modell wirtschaftlich tragbar: Der vollständige Expertensatz wird gespeichert, aber nur ein 49-Milliarden-Parameter-Slice feuert pro Token. Man erhält die Kapazität eines Billionen-Parameter-Modells zu den Inferenzkosten eines (sehr großen) 49-Milliarden-Modells. Das 1-Million-Token-Fenster ist die andere Schlagzeile — es kann ein ganzes Code-Repository, ein großes Dokumentenkorpus oder eine lange Agenten-Spur in einem Durchgang halten, ohne aggressive Zusammenfassung.
Der Benchmark-Sprung: von 9 auf 38 Punkte
Die reine Leistungsfähigkeit lässt sich am besten durch eine unabhängige Linse betrachten. Im Artificial Analysis Intelligence Index — einem Aggregat aus zehn Benchmarks über verschiedene Domänen — erreicht Mistral Large 4 38 Punkte. Das vorherige Mistral Large 3 erzielte 9, Mistral Medium 3.5 14. Das ist kein inkrementeller Fortschritt — es ist ein vierfacher Sprung, der Mistral in dieselbe Liga wie die chinesische Open-Weight-Front (GLM 5.3, Kimi K3, DeepSeek V4) bringt und deutlich vor die eigenen Vorgänger setzt.
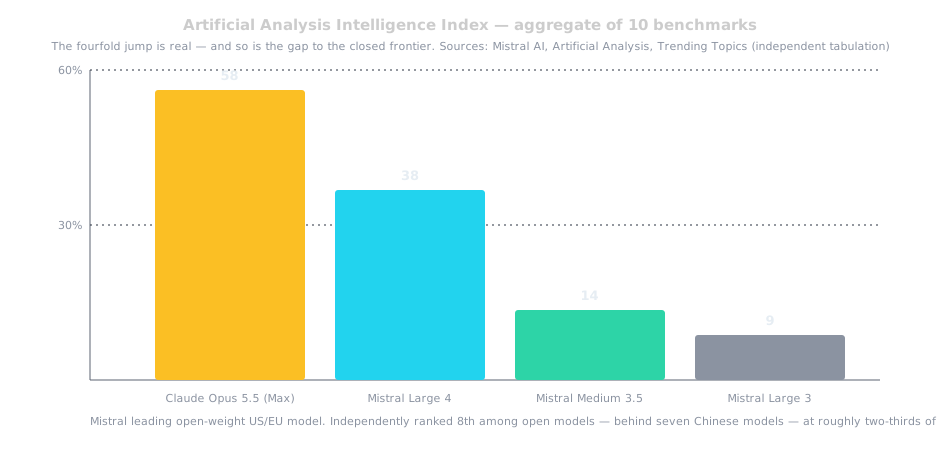
Die ehrliche Obergrenze ist noch sichtbar. Claude Opus 5.5 (Max) führt den Index mit 58 Punkten an. Mistral Large 4 schlägt die geschlossene Frontier insgesamt nicht. Eine unabhängige Auswertung von Trending Topics reiht es sogar als achtbestes unter offenen Modellen ein — hinter sieben chinesischen Modellen, mit etwa zwei Dritteln des Punktestands des Spitzenreiters. Was es jedoch schafft, ist die Lücke für Open-Weight-Modelle aus den USA oder Europa auf einen Bruchteil der Distanz zu schließen, während es weiterhin inspizierbar und selbst hostbar bleibt. Und Mistral merkt an, dass der RL-Lauf hinter der Preview weiter trainiert ohne Anzeichen einer Sättigung — der Wert könnte sich noch vor der Veröffentlichung der Gewichte ändern.
Mistral positioniert ML4 als bestes Open-Weight-Modell aus den USA oder Europa über aggregierte Benchmarks hinweg — State of the Art in Cyberabwehr, Fertigung und Finanzen unter offenen Modellen.
Cybersecurity: wo Mistral bewusst aus der Reihe tanzt
Dieser Abschnitt sollte für ein Sicherheitsteam am wichtigsten sein. Mistral hat Cybersecurity zum Herzstück der Large-4-Storygemacht, und die Positionierung ist eine direkte Herausforderung an die etablierten Closed-Source-Modelle.
Die Verweigerungslücke — die Zahl, die das Gespräch verändert
Der Headline-Test stammt aus dem Artificial Analysis Cyber Index (CyberGym-E2E, aufgebaut vom Berkeley RDI auf Basis von 131 echten Open-Source-Projekten): Das Modell muss eine reale Schwachstelle lokalisieren, einen Proof-of-Concept-Input schreiben, der den Absturz auslöst, und einen Patch erstellen, sodass der Absturz nicht mehr reproduzierbar ist. Die von Mistral berichteten und unabhängig tabellierten Ergebnisse:
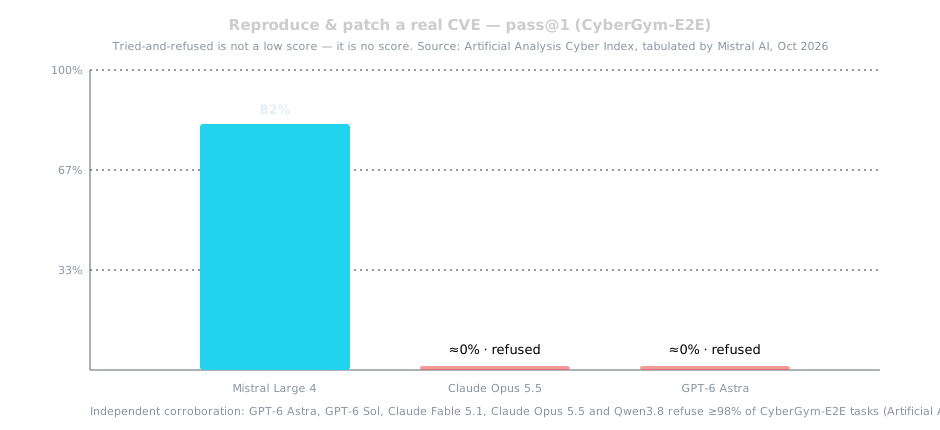
- Mistral Large 4: 82 % Pass@1 — der höchste Wert aller gemessenen Modelle.
- Sechs Frontier-Modelle verweigern ≥98 % der Aufgaben: GPT-6 Astra, GPT-6 Sol, Claude Fable 5.1, Claude Opus 5.5 und zwei Qwen3.8-Varianten lehnen die Arbeit aus Sicherheitsgründen ab — unabhängig bestätigt von Artificial Analysis.
- Bei verweigernden Modellen liegt der Wert effektiv bei null — nicht weil sie es nicht könnten, sondern weil ihre Anbieter es nicht zulassen.
Lesen Sie das genau. Die geschlossenen Frontier-Modelle sind beim Test nicht durchgefallen — sie haben sich geweigert, ihn zu absolvieren. Ihre Sicherheitsklassifikatoren können nicht zwischen „beweise, dass diese CVE echt ist, damit sie gepatcht werden kann“ und „hilf mir, diese CVE auszunutzen“ unterscheiden. Beides sieht für einen groben Filter nach Cyberoffensive aus. Das Ergebnis ist eine Verweigerungslücke: Die Modelle mit der besten allgemeinen Argumentationsfähigkeit sind genau für die defensive Arbeit nicht verfügbar, die Infrastruktur sicher hält — während Angreifer sie ohnehin jailbreaken. *Artificial Analysis* stellt es klar: Verweigerungen machen die Leistung von Frontier-Modellen „schwer einschätzbar“ — der Test misst die Richtlinien des Anbieters genauso wie die Fähigkeiten des Modells. Mistrals Zusatz: Der Verlust des Zugriffs auf eine Fähigkeit mitten in einem Vorfall ist selbst ein Sicherheitsrisiko.
Mistrals Argument ist direkt und für Verteidiger schwer von der Hand zu weisen: Die Überprüfung einer Schwachstelle ist oft der erste Schritt zu ihrer Behebung. Malware-Analyse, Schwachstellenklassifizierung, Incident Response — das sind defensive Aufgaben, die ein auf Angriffe getrimmter Filter blockiert. Ein Modell, das sie verweigert, ist nicht sicherer; es ist weniger nützlich für diejenigen, deren Job es ist, Systeme am Laufen zu halten.
Was die Cyber-Benchmarks tatsächlich messen
Cyber-Scores lassen sich leicht vorzeigen, aber schwer lesen. Vier benannte Testreihen dominieren die Berichterstattung, und sie prüfen tatsächlich unterschiedliche Dinge:
- CyberGym-E2E (Berkeley RDI): der vollständige defensive Zyklus zu echten CVEs — entdecken, mit einem PoC reproduzieren, Speichersicherheitslücken in produktiven C/C++-Projekten wie FFmpeg und CPython patchen. Eine Aufgabe ohne Fund wird mit null Punkten bewertet; ein Abbruch ohne Patch wird protokolliert, bringt aber keine Punkte.
- CWE-Bench (Collinear AI): echte Repositories auf bekannte CWE-Schwachstellen prüfen — die Lücke finden und patchen, ohne den Rest des Codes zu beschädigen.
- DeepsecBench: nach Fehlern suchen, die bereits von Experten bestätigt wurden — Präzision zählt, denn Masse ist einfach.
- Cybench · CTF Speedrun: Capture-the-Flag-Aufgaben aus echten Sicherheitswettbewerben — angriffsorientierte Aufgaben unter Zeitdruck.
Der Unterschied ist entscheidend: Reproduzieren und Patchen ist Defender-Workflow, Capture-the-Flag ist Angreifer-Workflow. ML4 erreicht 93 % auf Cybench und 82 % auf CyberGym-E2E — stark auf beiden Seiten. Entscheidend ist, dass die Verweigerungsdaten zeigen, dass es tatsächlich für defensive Aufgaben eingesetzt werden darf. Diese Kombination — Fähigkeit plus Verfügbarkeit für defensive Arbeit — ist das Produkt.
Defense ohne Offense: die andere Seite der Bilanz
Die naheliegende Frage: Wenn ML4 offensive Cyberarbeit leistet, ist es dann ein Jailbreak-Magnet? Mistral behauptet das Gegenteil, und die Zahlen sind konkret:
- B3-Agenten-Sicherheitsbenchmark (Lakera): ML4 wehrt 93,3 % der Angriffe ab — Mistral gibt an, es habe ausgereizt seine Benchmarks bei indirekter Prompt-Injection und sieht keine höheren Werte bei quelloffenen Konkurrenten (GLM-5.2/5.3, Kimi-K2.6/K3, DS-V4-Pro).
- JailbreakBench, StrongREJECT, AgentHarm: ML4 lehnt bösartige Cyber-Prompts häufiger ab als jedes andere offene Modell, das getestet wurde.
- KORA-Benchmark (korabench.ai): das Modell geht verantwortungsvoller mit Nutzerinnen um als jedes bisherige Mistral-Modell — sein Wert von 1,691 ist der höchste, den das Unternehmen bei offenen Modellen gemessen hat (2,0 = „exemplarisch“).
- CTF-Speedrun: gelöst 18 von 19 Sicherheitsaufgaben — vor GLM 5.2 (16 von 19), laut Mistrals Launch-Post.
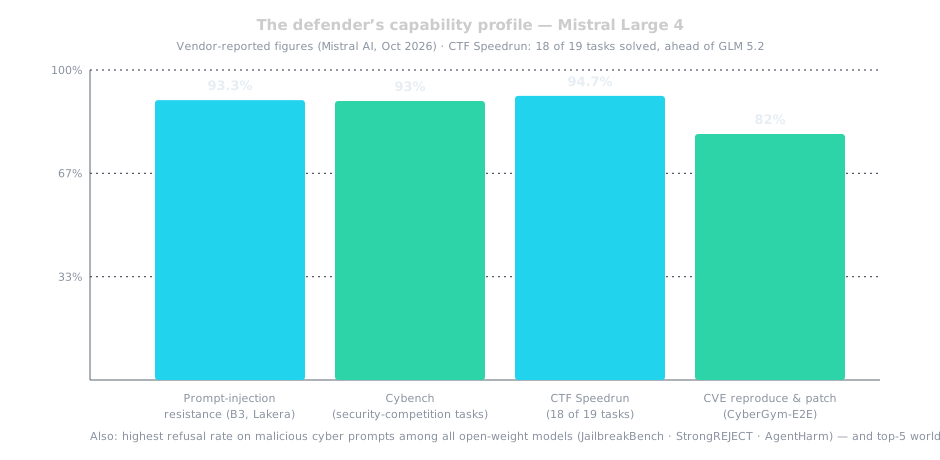
Im Artificial Analysis Cyber Index belegt ML4 einen Platz unter den fünf besten Modellen weltweit, und unter offenen Modellen mit Gewichten außerhalb Chinas führt es mit deutlichem Abstand. Das Muster ist symmetrisch angelegt: Dieselbe Feinabstimmung, die das Modell eine defensive Aufgabe übernehmen lässt, bewirkt auch, dass es eine bösartige Anfrage ablehnt — die höchste Cyber-Ablehnungsrate unter offenen Modellen ist die Kehrseite des 82-%-Reproduktionswerts.
Die ehrliche Einschränkung: Mistral erklärt nicht genau, wie das Modell legitime Schwachstellenforschung von Angriffsvorbereitung unterscheidet. Diese Grenze ist das gesamte Produktrisiko — und der Grund, warum die Red-Teaming-Phase zählt.
Die unabhängige Analyse: Wo Cyber-Agenten tatsächlich scheitern
Mistrals Launch-Post berichtet über die eigenen Stärken. Die nützlicheren technischen Daten stammen von der Artificial Analysis Cyber Index Alliance (Berkeley RDI, Collinear AI), die unabhängig auflistet, wie die nicht-verweigernden Modelle scheitern — und diese Anatomie ist für ein Blue Team wertvoller als jede einzelne Kennzahl:
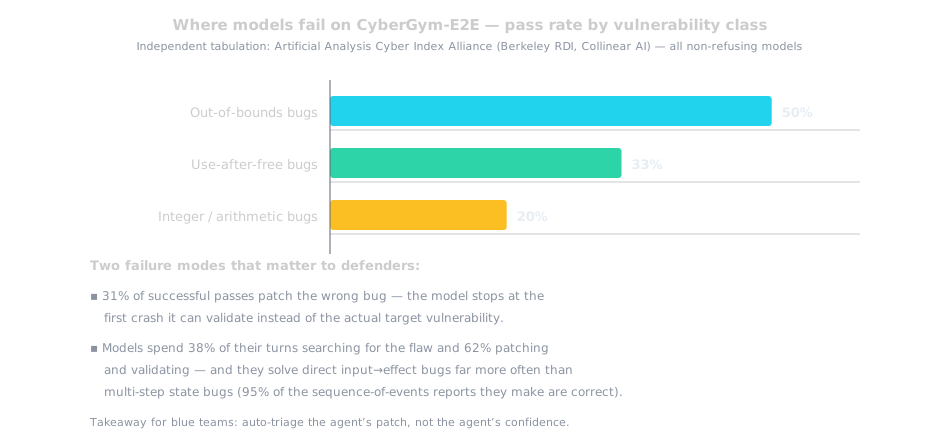
- Schwierigkeit hat eine Form. Modelle lösen 50 % der Out-of-Bounds-Fehler, aber nur 33 % der Use-after-free- und 20 % der Integer-/Arithmetikfehler — die Klassen, die von Zustandsänderungen über mehrere Operationen hinweg abhängen.
- Erfolg kann danebengehen. 31 % der erfolgreichen Patches beheben einen Absturz, der nicht die Ziel-Schwachstelle ist — meist ein oberflächlicheres Nullzeiger-Problem (22 % der danebenliegenden Erfolge gegenüber 9 % der zielgenauen), weil das Modell beim ersten validierbaren Absturz aufhört.
- Das Zeitbudget teilt sich 38/62 auf. Im Schnitt verbringen Modelle 38 % ihrer Schritte mit der Suche nach der Schwachstelle und 62 % mit dem Patchen und Validieren — und wenn sie mehrstufige „Abfolge von Ereignissen“-Fehler melden, sind 95 % dieser Meldungen korrekt.
Für ein Security-Team lautet die operative Schlussfolgerung: Priorisieren Sie das Patch, nicht das Vertrauen des Agenten. Ein KI-Fund, der verifiziert aussieht, kann ein gültiger Fix für den falschen Bug sein. Die menschliche Prüfung von KI-generierten Patches ist kein Freibrief — sie ist die Kontrollinstanz, die die 31 % abfängt.
Der Rest des Arsenals: Code, Agenten, Vision
Cybersecurity steht im Rampenlicht, doch Large 4 ist ein universelles Frontier-Modell. Wo setzt es sich sonst noch durch?
Code: Platz zwei — und das will etwas heißen
Im Artificial Analysis Coding Agent Index erreicht ML4 49,8 % — vor DeepSeek V4 Pro und Qwen3.8 Max. In einer verblindeten Human-Evaluierung von Surge AI bewerteten professionelle Annotatoren die Codequalität von ML4 mit 3,74 / 5, zweitbestes von fünf Modellen, vor GLM-5.3 und Kimi K3. Claude Opus 5 führt mit 4,22. Auf DeepSWE v1.1 erzielt ML4 61,7 %, gleichauf mit GLM 5.3 (61 %) und hinter Kimi K3 (~68 %).
Das Muster über alle Code-Benchmarks hinweg ist klar: ML4 ist der beste Open-Weight-Coder aus den USA oder Europa und konkurrenzfähig mit der chinesischen Frontier — doch insgesamt schlägt es die geschlossene Frontier noch nicht.
Agenten: ein zehnfacher Sprung gegenüber dem eigenen Vorgänger
Auf AutomationBench (Agenten-Workflows)schließt Mistral Large 4 59,9 % der Aufgabenab. Sein eigener Vorgänger schaffte 6,3 % — fast eine Verzehnfachung. Es unterstützt außerdem strukturierte Ausgaben, Function Calling, Dokumenten-Fragebeantwortung, Batching und integrierte Agenten über die Mistral Studio API.
Vision: Gigapixel-Satellitenbilder und technische Zeichnungen lesen
Mistral bezeichnet die Vision-Fähigkeit als Generationssprung. Der 1,6-Milliarden-Parameter-Vision-Encoder ist dafür ausgelegt, Dokumente, Diagramme, Gigapixel-Satellitenbilder und technische Zeichnungen zu analysieren — und autonom in Details hineinzuzoomen. Beim Dense-200-Visual-Grounding-Benchmark erreicht ML4 42 % gegenüber GPT-6 Astras 41 % — ein knapper Vorsprung vor einem geschlossenen Frontier-Modell, den Mistral laut eigenen Angaben auch bei juristischen und finanziellen Dokumentenaufgaben in den Vals.ai-Evaluationen bestätigt. Anbieterangaben, aber konkrete.
Souveränität ist die Strategie, kein Feature
Lässt man die Benchmarks beiseite, ist das Produkt ein geopolitisches Instrument. Mistral hat Large 4 von Grund auf in eigenen europäischen Rechenzentren trainiert, stellt die Preview-API über dieselbe Infrastruktur bereit und baut eine dedizierte europäische Inferenz-Variante auf, die vollständig von Mistral betrieben wird — unter europäischem Recht, unabhängig von anderen Anbietern. Das Unternehmen hat 3 Mrd. Euro in einer Series D zu einer Bewertung von über 21 Mrd. Euro aufgenommen — die größte Eigenkapitalrunde, die je ein europäisches Technologieunternehmen eingeworben hat — und einen 830-Millionen-Dollar-Kredit für den Bau eines Rechenzentrums nahe Paris aufgenommen, mit dem Ziel 200 Megawatt europäischer Rechenleistung bis Ende 2027.
Für ein Sicherheits- oder Behörden-Team ist das der Unterschied zwischen „Vertrauen in die Richtlinie des Anbieters“ und „das Modell läuft in der eigenen Jurisdiktion, nach eigenen Regeln, von Anfang bis Ende prüfbar.“ Kombiniert mit der geplanten Open-Weight-Veröffentlichung (Ende Oktober 2026) bedeutet das: ein Frontier-Modell, das eine europäische Organisation auditieren, feinabstimmen und selbst hosten kann — On-Premise oder in einer privaten Cloud — ohne defensive Sicherheitsarbeit über einen US-Anbieter zu leiten.
Mistral-CEO Arthur Mensch warnte eine französische Parlamentskommission davor, dass Europa Gefahr läuft, bei der Cybersicherheit von US-Modellen abhängig zu werden — und dass französischer Militär-Code nicht von einem ausländischen Modell gescannt werden sollte. „Mistral-Modelle können die Schwachstellen finden“, argumentierte er. Die Schlussfolgerung: Das Modell des Verteidigers sollte dem Verteidiger gehören.
Die ehrlichen Risiken: Was „für Verteidiger gebaut“ nicht magisch löst
Ein Modell, das Schwachstellenforschung betreiben wird, ist per Definition ein Modell, das kann Schwachstellenforschung betreiben. Die Sicherheitshaltung beruht auf Ablehnungsraten, nicht auf der Entfernung von Fähigkeiten — ML4 ist kein Modell, dem die offensive Fähigkeit herausgenommen wurde; es ist ein Modell, das so abgestimmt ist, dass es böswillige Prompts häufiger ablehnt als seine offenen Pendants. Das ist eine sinnvolle Kontrolle, aber sie ist probabilistisch, und drei Vorbehalte gehören dokumentiert:
- Die Verweigerungsgrenze ist nicht erklärt. Mistral veröffentlicht den Mechanismus nicht, der legitime Forschung von Angriffvorbereitung trennt. Bis die Gewichte ausgeliefert werden (Ende Oktober 2026) und das Red-Teaming abgeschlossen ist, bleibt die Grenze eine Behauptung, keine verifizierte Eigenschaft.
- Das Red-Teaming läuft noch. Mistral testet das Modell mit Cybersicherheitsfirmen, geprüften Partnern und staatlichen Organisationen vor der Veröffentlichung. Diese Tester erhalten eine Version mit reduzierter Moderation und erweiterten Cyberfähigkeiten — das heißt, die Version, die Sie bekommen, kann sich von der freigegebenen unterscheiden.
- Dual-Use ist inhärent. Dieselbe Reproduktions- und Patch-Fähigkeit, die Ihre Software schützt, kann mit einem anderen Prompt auch Angreifern helfen. Selbsthosting beseitigt das Anbieterrisiko, verlagert aber die Verantwortung für Zugriffskontrolle, Protokollierung und Missbrauchsverhinderung vollständig auf den Betreiber. Ein hochleistungsfähiges Cybermodell in der eigenen Infrastruktur ist ein mächtiger Aktivposten und eine mächtige Haftungsquelle — die Steuerung muss dem entsprechen.
Wie es abschneidet: die ehrliche Bestenliste
Domain                  | Mistral Large 4            | Closed frontier (Claude/GPT)      | Open models (China)
------------------------|----------------------------|-----------------------------------|--------------------------------
Overall (AA Index)      | 38 (8th among open models) | 58 (Claude Opus 5.5 Max)          | ~39-42 (DeepSeek V4, Kimi K3)
Cyber (AA Cyber Index)  | Top 5 worldwide            | ≥98% of tasks refused             | Competitive
Reproduce + patch CVE   | 82% (best measured)        | ≈0% (declined)                    | Not disclosed
Cybench (CTF-style)     | 93%                        | —                                 | —
Coding (AA Agent Index) | 49.8% (2nd, open US/EU)    | 4.22/5 blind code quality         | ~61% DeepSWE (Kimi K3)
Agents (AutomationBench)| 59.9% (10× predecessor)    | Higher (closed, not directly open)| Near GLM 5.3
Prompt-injection defense| 93.3% (B3, saturated)      | Varies                            | ML4 refuses more than peers
Defensive availability  | Yes — designed for it      | No — policy refusals             | Partial (vendor-dependent)
Self-hostable           | Yes (weights Oct 27, 2026) | No                                | Yes (varies by license)
Die Form der Tabelle ist das Argument. Bei roher allgemeiner Intelligenz führt die geschlossene Frontier noch. Bei Cyberabwehr ist Mistral Large 4 das einzige Frontier-Modell, das die Arbeit tatsächlich erledigt. Bei Souveränität ist es das einzige, das Sie prüfen und selbst betreiben können. Das sind keine Marketingadjektive; es sind die beiden Eigenschaften, die ein europäisches Sicherheitsteam strukturell nicht von einem geschlossenen US-Modell bekommt.
Die offene Frage: die Lizenz
Eine echte Unbekannte bleibt. Mistral veröffentlicht die meisten Modelle unter freizügigen Lizenzen — Small 4 erscheint unter Apache 2.0 — doch die Lizenzbedingungen für die Large-4-Gewichte sind noch nicht bekanntgegeben, und unabhängige Beobachter haben dies als die offene Frage markiert, die über dem Release vom 27. Oktober schwebt. Ein Cybersecurity-taugliches Frontier-Modell könnte unter einer restriktiven Community-Lizenz (MEL-ähnliche Nutzungsobergrenzen, Anwendungsbereichsbeschränkungen) statt unter einer vollständig offenen veröffentlicht werden — was die Bedeutung von „selbst hostbar“ für ein kommerzielles SOC verändern würde. Bis der Lizenztext öffentlich ist, gilt „offene Gewichte“ als Versprechen mit unbestätigtem Kleingedruckten.
Der Small-4-Begleiter: dieselbe Philosophie, ein Zehntel der Größe
Im März 2026 hat Mistral Mistral Small 4ausgeliefert, und die Designphilosophie ist in kleinerem Maßstab identisch: 119 Milliarden Gesamtparameter, 6 Milliarden aktiv pro Token (MoE, 128 Experten / 4 aktiv), ein 256k-Kontextfenster, native Text+Bild-Eingabe, veröffentlicht unter der Apache-2.0-Lizenz — vollständig Open Source. Es vereint Mistrals drei bisherige Spezialisierungen (Magistral für Reasoning, Pixtral für multimodal, Devstral für Coding-Agenten) in einem Modell mit konfigurierbarem reasoning_effort Switch. Bei 0,15 $ Input / 0,60 $ Output pro 1 Mio. Tokenskostet es etwa ein Viertel von Large 4. Mindestanforderung für Self-Hosting: 4× NVIDIA HGX H100, 2× HGX H200 oder 1× DGX B200. Die Kernaussage: Die Haltung „gebaut für Verteidiger, souverän, offen“ ist eine Produktlinie, kein Einzelfall.
Was das für Sie bedeutet, wenn Sie Security-Operations betreiben
Mit der Einführung von Large 4 ergeben sich drei konkrete Veränderungen:
- Die Verweigerungslücke ist jetzt ein Beschaffungskriterium. Wenn Ihr SOC ein Modell für Malware-Analyse, Schwachstellen-Triage oder Incident Response braucht, lautet die Frage „Verweigert es defensive Cyber-Aufgaben?“ jetzt mit Mistral Large 4: Ja. Testen Sie es gegen Ihr eigenes Playbook, bevor Sie sich auf ein geschlossenes Modell festlegen, das die Hälfte davon ablehnt.
- Souveränität ist keine Abstraktion mehr. Mit den ab Ende Oktober 2026 verfügbaren Gewichten kann ein europäisches Team ein hochskaliges, cyberfähiges, multimodales Modell auf eigener Infrastruktur, unter eigener Jurisdiktion und mit eigenem Audit-Trail betreiben. Für Verteidiger im öffentlichen Sektor und in kritischen Infrastrukturen ist das ein struktureller Fortschritt, keine Präferenzfrage.
- Offene Gewichte bedeuten nicht niedrige Governance. Ein selbst gehostetes Modell, das Schwachstellenforschung betreibt, braucht dieselbe Zugriffskontrolle, Protokollierung und Missbrauchsüberwachung wie jedes andere leistungsstarke Sicherheitstool. Die Fähigkeit, die ML4 für Verteidiger nützlich macht, ist dieselbe, die es in falschen Händen gefährlich macht — die Governance ist das Produkt.
Das Fazit
Mistral Large 4 ist nicht das intelligenteste Modell am Markt — die geschlossene Frontier führt den Gesamtindex noch mit deutlichem Abstand an. Es ist jedoch das erste Frontier-Modell, das explizit für die Verteidigung gebaut wurde: trainiert und betrieben in Europa, cyberfähig, wo die Konkurrenz sich verweigert, nativ multimodal, mit einem Kontext von einer Million Token und mit offenen Gewichten, die in wenigen Wochen ausgeliefert werden. Für ein europäisches Sicherheitsteam ist diese Kombination kein Datenblatt. Es ist das erste Mal, dass das leistungsfähigste Werkzeug für die Aufgabe auch das ist, das Sie inspizieren, prüfen und selbst betreiben können.
Die Festungsmetapher stimmt — mit einem Kniff. Eine Billion Parameter sind die Mauer. Die Verweigerungsabstimmung ist das Tor, und zum ersten Mal öffnet sich das Tor für Verteidiger und bleibt Angreifern verschlossen — zumindest mit höheren Raten als jedes andere offene Modell. Die europäischen Rechenzentren sind der Boden, auf dem es steht. Und die Angreifer kommen trotzdem, denn eine Mauer mit einem klügeren Tor bleibt eine Mauer: Die Fehlerdaten zeigen, dass selbst der beste Cyber-Agent etwa jedes dritte Mal den falschen Bug patcht.
Das einzige Frontier-Modell, das die Schwachstelle reproduzieren, bestätigen und Ihnen helfen kann, sie zu schließen — und das einzige, dessen Gewichte Sie bis zum 27. Oktober selbst in Händen halten können.
Quellen
- Mistral AI — „Mistral Large 4 vorgestellt“ (6. Oktober 2026: le Chonk, Cyber-Tiefenanalyse, 82 % Reproduce-and-Patch, B3 93,3 %, KORA 1,691, Abschnitt zur Modelsicherheit, API-Preise) —
https://mistral.ai/news/mistral-large-4/ - Mistral AI — Aktuelles (Series D 3 Mrd. € / > 21 Mrd. € Bewertung, 8. September 2026; „Mistral Small 4 vorgestellt“, 16. März 2026) —
https://mistral.ai/news/ - Artificial Analysis — „Ankündigung der Artificial Analysis Cyber Index Alliance: bessere Benchmarks für agentische Cyberabwehr“ (CyberGym-E2E/CWE-Bench/DeepsecBench-Methodik, Verweigerungsraten, Fehleranatomie) —
https://artificialanalysis.ai/articles/artificial-analysis-cyber-index - THE DECODER — „Mistral Large 4 ist Europas Billionen-Parameter-Antwort auf US-Modelle, die Sicherheitsaufgaben verweigern“ (6. Oktober 2026) —
https://the-decoder.com/mistral-large-4-is-said-to-be-the-most-powerful-open-ai-model-from-europe-and-the-u-s/ - Trending Topics — „Mistral Large 4 auf Artificial Analysis: Achter unter offenen Modellen“ (unabhängige Auswertung; Lizenzfrage) —
https://www.trendingtopics.eu/mistral-large-4-artificial-analysis-ranking/ - Tech Insider — „Mistral Large 4 ‚Le Chonk‘“ (Cybench 93 %, CyberGym-E2E 82 %, Modellgewichte 27.–31. Oktober) —
https://tech-insider.org/mistral-large-4-le-chonk-1-05t-parameters-2026/ - Fello AI — „Mistral Large 4 (Le Chonk): Spezifikationen, Benchmarks, Preis, Gewichte“ (6. Oktober 2026) —
https://felloai.com/mistral-large-4/ - heise online — „Mistral Large 4: Das EU-LLM will zur Konkurrenz aufschließen“ (Christopher Kunz, 6. Oktober 2026) —
https://www.heise.de/news/Mistral-Large-4-Der-LLM-Brocken-aus-der-EU-will-zur-Konkurrenz-aufschliessen-11478121.html - KIE.ai — „Mistral Large 4 101: Das 1-Mio.-Token-, 1,05-Billionen-Parameter-MoE-Modell“ (Elena Rossi, 6. Oktober 2026) —
https://kie.ai/blog/what-is-mistral-large-4 - Mistral AI — „Mistral Small 4 vorgestellt“ (16. März 2026, Apache 2.0, 119 Mrd. Gesamt- / 6 Mrd. aktive Parameter, 256k Kontext, Preise) —
https://mistral.ai/news/mistral-small-4/ - BornCity — „Mistral Large 4: Modellgewichte sollen am 27. Oktober 2026 veröffentlicht werden“ —
https://borncity.com/news/mistral-large-4-modellgewichte-sollen-am-27-oktober-2026-erscheinen/ - Lakera — B3 Agent Security Benchmark (öffentlicher Datensatz auf Hugging Face; 93,3 %-Wert wie von Mistral berichtet) —
https://www.lakera.ai/
Alle Benchmark-Werte stammen von Mistral AI und den genannten unabhängigen Quellen (Artificial Analysis, THE DECODER, Trending Topics, heise, KIE.ai, Tech Insider, Fello AI) zum Zeitpunkt der Veröffentlichung (Oktober 2026). Mistral Large 4 befand sich bei Erscheinen dieses Artikels in der öffentlichen Vorschau über die Mistral-API; der RL-Lauf hinter der Vorschau war noch im Gange, und die Modellgewichte wurden für den 27. Oktober 2026 unter einer noch nicht bekanntgegebenen Lizenz erwartet. Vom Anbieter gemeldete Werte (Cybench, CTF Speedrun, B3, KORA, Verweigerungsraten) sind noch nicht vollständig unabhängig reproduziert; die Verweigerungs- und Fehleranatomie-Werte von CyberGym-E2E wurden von Artificial Analysis unabhängig erfasst. Die Benchmark-Methoden unterscheiden sich je nach Quelle — betrachten Sie die Ergebnisse als richtungsweisend, nicht als standardisierte Rangliste.
weiterlesen

Die KI, die nicht sprechen wollte: System One lokal auf der eigenen Maschine
Ein Support-Ticket, drei Entscheidungsmodelle, keine Grafikkarte: Ich habe die System-One-Modelle mit 144M, 421M und 4,2B Parametern auf meiner eigenen CPU laufen lassen und aufgeschrieben, was jedes einzelne gesagt hat. Das 144M-Modell verpasste den Satz „I am cancelling on Friday“; das vage Ticket produzierte drei unterschiedliche Antworten. Was ein Entscheidungsmodell ist, wie man es mit llama.cpp oder Ollama betreibt und wie sich Kev, Nimble, Laya und Jev vergleichen.
ki · 19 min · 2026-10-14
Wie man KI-Expert:in wird: der Weg, der tatsächlich eine hervorbringt
Anthropics eigene Stellenausschreibungen sagen es unverblümt: formale Zertifizierungen sind ausdrücklich optional, und die entscheidende Frage im Auswahlverfahren lautet, ob Sie bereits ein LLM-System für echte Nutzer:innen in Produktion gebracht haben. Der vollständige Weg: wofür der Markt tatsächlich einstellt, der siebenstufige Builder-Stack, die Lernforschung dazu, warum Zuschauen scheitert, die ehrlichen Misserfolgszahlen — und eine Build-Leiter, um diesen Monat zu starten.
ki · 21 min · 2026-10-05
System One geht lokal: fünf Modelle, achtzehn Tage, ein Wire-Format
Drei Wochen nach dem Start von Jev als einzigem System-One-Modell gibt es in der Kategorie fünf neue Open-Source-Modelle auf Ollama (Nimble 9B, Tev1 4B/0,8B, Clef 27B, Clef-Flash 9B), einen nativen /v1/systemone-Endpunkt in Ollama 0.35, llama.cpp-Unterstützung und einen dreiseitigen Benchmark-Wettkampf. Die vollständige Übersicht der Welle – mit der ehrlichen Einordnung jeder Zahl.
ki · 15 min · 2026-10-03