

technik
DuckDB: Ein SQL-Motor für alle Datenbanken, Dateien, Lakehouses, Modelle und Karten
Ihre Daten liegen in Postgres, in Parquet auf S3, in einer alten SQLite-Datei, in einem pandas-DataFrame, in einem GeoPackage und in einem Ordner mit JSON-Dumps. DuckDB verbindet all das mit reinem SQL — ohne Server, ohne Pipelines. Eine umfassende, quellenbasierte Tour vom vektorisierten Engine-Design über R-Tree-Joins bis zu RAG.
KI-Entwurf · geprüft und bearbeitetDieser Text wurde mit KI als Erstentwurf erstellt und anschließend von der Autorin bzw. dem Autor geprüft und bearbeitet, die bzw. der die redaktionelle Verantwortung dafür trägt.
DuckDB: Ein SQL-Motor für alle Datenbanken, Dateien, Lakehouses, Modelle und Karten
Moderne Datenarbeit ist eine logistische Herausforderung. Die Messwerte liegen in PostgreSQL, die Exporte sind Parquet-Dateien auf S3, das Altsystem läuft auf SQLite, das Data-Science-Team arbeitet mit pandas und Arrow, die KI-Pipeline braucht Embeddings, zerlegte Texte und Vektorsuche, das GIS-Team liefert GeoPackages. Jede dieser Inseln hat ihr eigenes Abfragewerkzeug, ihren eigenen Dialekt, ihre eigene Deployment-Geschichte — und die Verbindung dazwischen ist meist ein fragiles Skript.
DuckDBs Ansatz ist fast schon provokant einfach: ein prozessintegrierter, spaltenorientierter, transaktionaler SQL-Motor, der sich direkt an fast alles anhängen lässt — und analytische Abfragen über die Grenzen hinweg ausführt, ohne etwas zu verschieben. Dieser Artikel ist eine detaillierte Tour durch die Architektur, die Konnektoren, die Lakehouse-Formate, den KI-Stack und die Geodaten-Erweiterung, die sich still und leise zu einer ernsthaften PostGIS-Alternative für Analysen entwickelt hat. Alles Folgende basiert auf Primärquellen (Papers, Dokumentationen, Engineering-Blogs), und jeder Befehl im Walkthrough-Abschnitt wurde vor der Veröffentlichung mit DuckDB v1.5.5 ausgeführt und verifiziert.
„The immense popularity of SQLite shows that there is a need for unobtrusive in-process data management solutions. However, there is no such system yet geared towards analytical workloads.“ — Raasveldt & Mühleisen, DuckDB: an Embeddable Analytical Database, SIGMOD 2019
1. Was DuckDB ist — und was es bewusst nicht ist
DuckDB ist ein Open-Source- (MIT), prozessintegriertes relationales DBMS, spezialisiert auf OLAP — langlaufende analytische Abfragen, die große Teile der Daten scannen, aggregieren und joinen. Es läuft nicht als Server, den Sie installieren und warten; es läuft innerhalb Ihres Prozesses, wie SQLite, und stellt sich über APIs für Python, R, Java, Node.js, Rust, Go, C/C++ zur Verfügung — und via DuckDB-Wasm auch im Browser-Tab.
Ein häufiges Missverständnis, das das Projekt explizit widerlegt, ist die Annahme, DuckDB sei eine „In-Memory-Datenbank“. Es kann im Speicher laufen, ist aber keine: Es nutzt den Speicher als Cache, unterstützt vollständig persistente Datenspeicherung im nativen Ein-Datei-Format und lagert Operationen, die größer als der verfügbare Speicher sind, auf die Festplatte aus. Die einzelne Datei enthält alles — Tabellen, Views, Indizes, Makros — in einem Design, das bewusst von SQLite inspiriert ist, mit einem Write-Ahead-Log daneben und Block-Prüfsummen gegen Bitrot.
Der Motor selbst ist spaltenorientiert-vektorisiert: Statt Zeile für Zeile (PostgreSQL, MySQL, SQLite) oder Abfragen zu Maschinencode zu kompilieren (ein Weg, der schwere JIT-Abhängigkeiten mit sich bringt), interpretiert DuckDB Abfragen über Vektoren — Chargen von etwa 2.048 Werten pro Spalte in einem einzigen Schritt. Dieses „Vector-Volcano“-Modell, intellektuell von MonetDB/X100 übernommen, amortisiert den Interpretations-Overhead und hält den gesamten Motor portabel: keine externen Abhängigkeiten, kompiliert zu einer einzigen Amalgamation, lauffähig von Edge-Geräten bis zu Many-Core-Servern. Parallelisierung erfolgt morsel-driven; sekundäre Indizes sind adaptive Radix-Bäume; der SQL-Dialekt basiert auf PostgreSQL mit dokumentierten Abweichungen.
Transaktionen. DuckDB bietet ACID-Garantien durch eine bulk-optimierte Multi-Version Concurrency Control (MVCC), die sich am serialisierbaren HyPer-Modell orientiert. Ein Prozess kann schreiben; viele Prozesse können gleichzeitig im Read-Only-Modus lesen; eine einzelne Transaktion darf nur eine angehängte Datenbank schreiben. DuckDB besteht die transaktionalen Validierungstests von TPC-H, und das Write-Ahead-Log ermöglicht Crash-Recovery. Wofür es nicht gebaut ist, ist OLTP: Tausende gleichzeitige kleine Lese-Schreib-Transaktionen gegen eine Datei sind die Domäne von Postgres oder SQLite, nicht von DuckDB.
Die peer-reviewte Abstammung
Anders als die meisten Werkzeuge im modernen Daten-Stack basiert DuckDB auf veröffentlichter akademischer Arbeit — ein Grund, warum es eine „wissenschaftliche“ Betrachtung verdient:
- SIGMOD 2019 (Demo): „DuckDB: an Embeddable Analytical Database“ — Raasveldt & Mühleisen, DOI 10.1145/3299869.3320212. Die grundlegende These für die SQLite-förmige Lücke im analytischen Bereich.
- CIDR 2020: „Data Management for Data Science — Towards Embedded Analytics“ — das Architektur-Paper: vektorisierte Ausführung über JIT, Single-File-Speicher mit 256 KB-Blöcken und Checksums, HyPer-style MVCC, Zero-Copy-Übergabe an R und Python.
- VLDB 2022: „DuckDB-Wasm: Fast Analytical Processing for the Web“ (PVLDB 15(12), DOI 10.14778/3554821.3554847) — der Engine in den Browser.
- CIDR 2024: „MotherDuck: DuckDB in the Cloud and in the Client“ — hybride Query-Verarbeitung, die eine Abfrage zwischen Laptop und Cloud aufteilt, fast vollständig auf dem Erweiterungsmechanismus von DuckDB aufgebaut.
- Ein warnender Hinweis zur Zitierweise: ein häufig zitierter „SIGMOD 2022 DuckDB-Paper“ scheint nicht zu existieren — dblp, Crossref und die SIGMOD-2022-Proceedings führen kein solches Paper. Die nachweisbare Dokumentation besteht aus der Demo von 2019 und dem CIDR-2020-Paper. (Dies wurde überprüft, weil dieser Artikel nachweisbare Aussagen bevorzugt.)
Das Projekt entstand aus der Datenbank-Forschungsgruppe des CWI in Amsterdam — derselben Linie wie MonetDB und Vectorwise — und wurde von Mark Raasveldt und Hannes Mühleisen ins Leben gerufen. Es wird von der gemeinnützigen DuckDB Foundation betreut (die die Marke hält und die MIT-Lizenz dauerhaft festschreibt), während das Unternehmen DuckLabs das Kernteam beschäftigt.
2. Die Architektur auf einen Blick
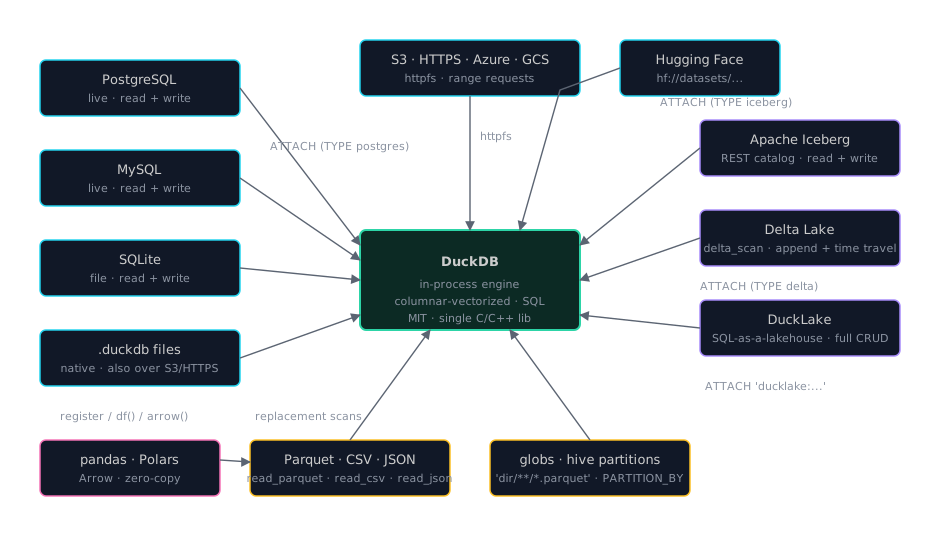
Die obige Abbildung fasst die gesamte These zusammen. Drei Verbindungsmechanismen decken alles ab: Table Functions (`read_parquet`, `read_csv`, `read_json`, `delta_scan`, `iceberg_scan`) für Dateien; Replacement Scans , die es ermöglichen, einen bloßen Dateinamen oder ein In-Memory-DataFrame als Tabelle erscheinen zu lassen; und die ATTACH-Anweisung, die eine externe Datenbank oder ein Lakehouse als erstklassigen Katalog einbindet, gegen den man wie gegen eine lokale Tabelle joinen kann. Der Rest dieses Artikels geht die einzelnen Ringe der Drehscheibe durch.
Versionslandschaft zum Zeitpunkt der Veröffentlichung
- v1.5.5 „Variegata“-Reihe (aktuell, Juli 2026): die Version, gegen die dieser Artikel verifiziert wurde. v1.5 führte den VARIANT-Typ für semistrukturierte Daten ein, beförderte GEOMETRY zum Core-Typ und überarbeitete die CLI.
- v1.4.x „Andium“ (LTS, September 2025): die erste Long-Term-Support-Version (ein Jahr Support), mit Datenbankverschlüsselung (AES-256-GCM via ATTACH), MERGE INTO und Iceberg-Writes.
- v2.0 „Cyanoptera“ (Vorschau August 2026): die angekündigte Hauptversion — DuckDB erhält einen Client-Server-Modus (das Quack-Protokoll mit CONNECT, sodass jeder DuckDB-Prozess seine Datenbanken über das Netzwerk für einen anderen bereitstellen kann), Trigger, engine-weite asynchrone I/O (mit großen Gewinnen bei Object Storage), einen neuen PEG-basierten SQL-Parser und ein Storage-Format v2.0.
- Governance-News (August 2026): DuckLabs gab bekannt, als Tochtergesellschaft zu AWS zu wechseln; DuckDB, DuckLake und die Extensions bleiben unter der Foundation MIT-lizenziert, mit der erklärten Absicht, dass Roadmap und Lizenzierung unverändert bleiben. Beobachtenswert, kein Grund zur Panik.
3. Datenbanken verbinden: ATTACH als universeller Adapter
DuckDBs am meisten unterschätzter Trick ist, dass es andere Datenbanken nicht als Importquellen behandelt, sondern als Live-Kataloge. Die Erweiterungen postgres, mysql und sqlite ermöglichen es, einen laufenden Server — oder eine einfache Datei — mit ATTACH einzubinden und dann gewöhnliche SQL-Abfragen darauf auszuführen, einschließlich Joins, die Systemgrenzen überschreiten. Die Daten werden zur Abfragezeit gelesen; nichts wird kopiert, sofern Sie es nicht explizit anfordern.
INSTALL postgres;  LOAD postgres;
ATTACH 'dbname=airdata user=postgres password=*** host=127.0.0.1 port=55432'
       AS pg (TYPE POSTGRES);

SELECT city, round(avg(pm25), 2) AS mean_pm25
FROM pg.public.sensors
GROUP BY city ORDER BY mean_pm25;
MySQL verwendet key=value-Verbindungsstrings, SQLite nimmt einfach einen Dateipfad — und da DuckDBs SQL PostgreSQL-ähnlich ist, fühlt sich der Roundtrip natürlich an. Die Funktionsmatrix über die drei einbindbaren Engines ist wirklich stark:
capability            PostgreSQL   MySQL   SQLite
query (live scan)         X         X        X
CREATE TABLE / INSERT     X         X        X
UPDATE / DELETE           X         X        X
ALTER TABLE / DROP        X         X        X
COPY table <-> Parquet    X         X        X
COPY FROM DATABASE        X         X        -
transactions              X         X*       X
pass-through SQL          postgres_query / mysql_query

* DDL is not transactional in MySQL itself.
Filters are pushed down where possible (PostgreSQL via an
experimental flag, on by default; parallel scans via ctid ranges).
Legacy *_attach() table functions are deprecated in favor of ATTACH.
Das macht DuckDB zu einem glaubwürdigen ETL-Hub: Daten aus Postgres ziehen, als partitionierte Parquet-Dateien ablegen, mit MySQL joinen, Ergebnisse zurückschreiben — alles in einem SQL-Skript, ganz ohne Airflow-Cluster. Vollständige Datenbankkopien sind eine einzige Anweisung: COPY FROM DATABASE pg TO local_duck;
Was hier praktisch verifiziert wurde
Für diesen Artikel wurde ein echter PostgreSQL-16-Container mit 5.000 Sensordatensätzen gestartet, aus Python eingebunden und die grenzüberschreitenden Abfragen von Anfang bis Ende getestet:
-- write through DuckDB into Postgres (full DML)
INSERT INTO pg.public.sensors (city, pm25) VALUES ('Graz', 8);
UPDATE pg.public.sensors SET pm25 = 99 WHERE city = 'Graz';

-- the money query: local Parquet JOIN live Postgres table
COPY (SELECT i AS id, i*0.1 AS noise FROM range(1,101) s(i))
     TO 'noise.parquet';
SELECT count(*)
FROM read_parquet('noise.parquet') p
JOIN pg.public.sensors s ON s.id = p.id
WHERE s.city = 'Vienna';
-- -> 100 rows, executed across two systems in one statement

-- force execution on the Postgres side itself
SELECT * FROM postgres_query('pg',
  'SELECT city, count(*) FROM sensors GROUP BY city');
Zwei ehrliche Fußnoten aus diesem Experiment: PostgreSQLs RETURNING Klausel wird für Updates über den Scanner noch nicht unterstützt, und postgres_query erwartet den Namen der eingebundenen Datenbank (wie 'pg'), nicht einen Verbindungsstring. Die Art von Detail, die erst auffällt, wenn man es tatsächlich ausführt — genau deshalb wurde es ausgeführt.
4. Dateien verbinden: CSV, JSON und die Parquet-Engine
DuckDBs Dateileser sind der Ort, an dem das Versprechen von „ohne Umstände“ eingelöst wird. Ein einfacher Dateiname ist eine Tabelle:
SELECT * FROM 'flights.csv';              -- yes, that is SQL
SELECT * FROM 'test/*.parquet';           -- globs work
SELECT * FROM read_parquet('s3://bucket/t/*.parquet');
CSV mit Sniffer. Der Reader erkennt automatisch Trennzeichen, Anführungs- und Escape-Zeichen, ob eine Kopfzeile existiert, sowie die Typen pro Spalte (standardmäßig werden 20.480 Zeilen gesampelt), wobei er von NULL, BOOLEAN, DATE, TIMESTAMP, BIGINT, DOUBLE bis VARCHAR aufsteigt. Falsche Vermutungen lassen sich pro Spalte überschreiben; fehlertolerante Ladevorgänge können fehlerhafte Zeilen in eine Reject-Tabelle umleiten, statt abzubrechen.
JSON als Zeilen. read_json erkennt Struktur und Typen automatisch (Array, NDJSON oder unstrukturiert), und die JSON-Erweiterung wird mit den meisten Distributionen ausgeliefert, einschließlich der -> / ->>-Extraktionsoperatoren. Die Überprüfung: eine zweizeilige NDJSON-Datei, verschachtelte Extraktion mit SELECT b.c FROM read_json('j.json') — funktionierte genau wie dokumentiert.
Parquet ist die Muttersprache. Hier kommt die spaltenorientierte Engine voll zum Einsatz, und es lohnt sich, die Mechanik präzise zu betrachten:
- Projection Pushdown: Es werden nur die Spalten von der Festplatte gelesen, die die Abfrage tatsächlich benötigt.
- Predicate Pushdown: Filter nutzen Parquet-Zonemaps (Min-/Max-Statistiken), um ganze Row-Groups zu überspringen — weshalb die Row-Group-Größe ein echter Stellhebel ist, kein Detail.
- Partitionierung in beide Richtungen: COPY ... (FORMAT parquet, PARTITION_BY (year, month)) schreibt hive-style-Verzeichnisse, und Lesevorgänge wandeln key=value-Ordner automatisch in Spalten um — wobei Filter auf diesen Spalten ganze Verzeichnis-Unterbäume auslassen.
- Heterogene Datensätze: union_by_name = true führt Schemata über Dateien hinweg zusammen; eine virtuelle Spalte filename ordnet jede Zeile ihrer Quelldatei zu (Standard seit v1.3.0).
- Metadaten als Tabellen: parquet_metadata(), parquet_schema() und ähnliche Funktionen ermöglichen die Inspektion des physischen Layouts direkt aus SQL.
-- verified: partitioned write, hive-partitioned read with pruning
COPY (SELECT i AS id, i%10 AS bucket, 'row'||i AS label
      FROM range(1000) s(i))
TO 'pq' (FORMAT PARQUET, PARTITION_BY (bucket));

SELECT count(*) FROM read_parquet('pq/**/*.parquet',
                                  hive_partitioning = true)
WHERE bucket = 3;      -- reads only bucket=3/, returns 100
Selbst DuckDBs eigene Datenbankdateien lassen sich auf diese Weise lesen: read_duckdb('my-*.duckdb', table_name = 'numbers') Abfragen greifen direkt auf Tabellen in .duckdb-Dateien zu — auch über HTTPS — ohne sie anzuhängen.
5. Remotedaten: S3, HTTPS, Azure, Hugging Face
Die httpfs-Erweiterung macht die gesamte Cloud-Objektspeicherebene zu einem Dateisystem. HTTP(S) ist nur lesend; die S3-API unterstützt Lesen, Schreiben, Globs und Multipart-Uploads. Die tragende Optimierung ist der HTTP-Range-Request: Ein Parquet-Footer teilt DuckDB mit, welche Byte-Bereiche die für eine Abfrage benötigten Spalten und Row-Groups enthalten, und nur diese Bereiche werden über das Netzwerk übertragen. Spaltenorientierte Formate und Remotespeicher sind füreinander gemacht; ein CSV über HTTPS wird dagegen im Wesentlichen vollständig heruntergeladen. Eine Remote-CSV-Abfrage wurde in einer Zeile verifiziert (ohne Anmeldedaten, automatisches Laden bei erster Verwendung):
SELECT count(*) FROM read_csv_auto(
  'https://raw.githubusercontent.com/mwaskom/seaborn-data/master/iris.csv');
-- -> 150
Die Authentifizierung ist zentral im Secrets Managergebündelt: ein einheitliches Modell für S3, R2, GCS, Azure, HTTP-Bearer-Tokens, Hugging Face und die Datenbank-Scanner — mit credential_chain-Unterstützung, die an das AWS SDK delegiert (Profile, SSO, assumed roles, IRSA). Hugging Face erhält ein eigenes URL-Schema, das stillschweigend über 150.000 öffentliche Datensätze in abfragbare Tabellen verwandelt:
SELECT count(*) FROM 'hf://datasets/cais/mmlu/astronomy/*.parquet';Dieselbe Mechanik ermöglicht partitionierte Schreibvorgänge zurück nach S3 und Zeit-Sicherungen wie Versions-Pinning für Buckets, in denen Objekte überschrieben werden.
6. Der Lakehouse: Iceberg, Delta, Lance und DuckLake
Tabellenformate sind der Punkt, an dem „Dateien abfragen“ zu „Tabellen auf Dateien verwalten“ reift. DuckDBs offizielle Position lautet, dass Iceberg, Delta, Lance und DuckLake gleichberechtigte Bürger sind — und ungewöhnlicherweise sind die Iceberg- und Delta-Unterstützung nativ implementiert (kein Java, kein Spark): Die iceberg-Erweiterung liest und schreibt Iceberg direkt, und die delta-Erweiterung baut auf delta-kernel-rs auf. Die Unterstützungsmatrix aus der offiziellen Dokumentation:
capability            DuckLake  Iceberg   Delta     Lance
read / write             X         X        X*        X
UPDATE / DELETE          X         X        -         X
time travel              X         X        X         -
CREATE TABLE             X         X        -         X
maintenance/compaction   X         -        -         X
query table changes      X         -        -         -

* Delta writes are blind appends only (no UPDATE/DELETE/CREATE);
  Iceberg writes need a catalog (REST) attach, landed Nov 2025.
-- Iceberg with a REST catalog: full DML, committed as snapshots
ATTACH 'warehouse' AS wh (
TYPE ICEBERG, SECRET iceberg_secret,
ENDPOINT 'https://catalog.example.com/catalog');
INSERT INTO wh.sales.events BY NAME SELECT ... ;
MERGE INTO wh.sales.events t USING new_events s ON (t.id = s.id)
WHEN MATCHED THEN UPDATE SET ...;
-- Delta: reads everywhere, appends, time travel
SELECT * FROM delta_scan('s3://bucket/table');
SELECT * FROM my_table AT (VERSION => 5);DuckLake — DuckDB Labs’ eigenes „SQL-as-a-Lakehouse“-Format, mit einer SQL-Datenbank als Katalog und Objektspeicher für Daten — ist von den vier Formaten das operationell ausgereifteste: vollständige CRUD-Operationen, Snapshots, Change-Queries und Verschlüsselung, plus ein Ein-Schritt-Migrationspfad von Iceberg-Metadaten via iceberg_to_ducklake. Apache Hudi hingegen wird nicht gleichberechtigt unterstützt (der historische Community-Reader wurde entfernt; heute wird nichts ausgeliefert). Das Katalog-Ökosystem ist breit: S3 Tables, AWS Glue, Cloudflare R2, Polaris, Lakekeeper, BigLake binden alle über denselben TYPE ICEBERG-Mechanismus ein.
7. DuckDB im KI-Stack
Die zweite Achse der These: DuckDB als Datenschicht für Machine-Learning- und LLM-Arbeiten. Die Grundlage bildet hier Apache Arrow. DuckDB und Arrow teilen eine Zero-Copy-Streaming-Integration — der eigene Engineering-Beitrag des Projekts bezeichnet sie als einzigartig genau aus diesem Grund —, die es ermöglicht, dass Folgendes gleichzeitig zutrifft:
- Python-Objekte direkt abfragen: Ein pandas-DataFrame, Polars-DataFrame, NumPy-Array oder Arrow-Table im Scope ist unter seinem Namen in SQL abfragbar (Replacement Scans), ohne Registrierung und ohne Kopie. Verifiziert:
duckdb.sql("SELECT x, upper(y) FROM df WHERE x > 1").fetchall()lief direkt gegen einen aktiven DataFrame. - Stream-Ergebnisse aus: .df(), .pl(), .fetchnumpy(), .to_arrow_table() und der Streaming-Export .to_arrow_reader(batch_size) decken die Exportrichtung ab — das offizielle Muster im PyTorch-Guide ist DuckDB, das einen Parquet-basierten Datensatz filtert/projiziert und Arrow-Batches direkt in die Tensor-Konvertierung streamt.
- Notebooks mit Datenmengen, die nicht in den Arbeitsspeicher passen: JupySQL (%sql magic, der gepflegte ipython-sql-Fork) und das reaktive marimo-Notebook sind dokumentierte First-Class-Clients — die ursprüngliche Motivation war der Speicher-Overhead von pandas bei der Visualisierung von Datensätzen, die nicht in den RAM passen.
- Ibis und Co.: Ibis’ Dataframe-API liefert DuckDB als Standard-Backend mit — ein weiteres Zeichen dafür, dass „SQL-Engine als Bibliothek“ die Integrationsform der Ära ist.
Retrieval: Volltext, Vektoren, hybrid
Volltextsuche (fts-Erweiterung). Ein vollständiger invertierter Index, implementiert in SQL (ursprünglich inspiriert von SQLite’s FTS5, Benchmark auf TREC-Kollektionen): PRAGMA create_fts_index mit dem Porter-Stemmer als Standard (29 Stemmer, 571 eingebaute englische Stoppwörter) und BM25-Ranking über ein generiertes match_bm25-Makro mit anpassbaren k1/b. Verifiziert funktionierend:
PRAGMA create_fts_index('docs', 'id', 'title', 'body');
SELECT id FROM (
  SELECT *, fts_main_docs.match_bm25(id, 'vectorized') AS score
  FROM docs) S
WHERE score IS NOT NULL ORDER BY score DESC;   -- -> exact hit
Der dokumentierte Vorbehalt ist für Pipelines relevant: Der FTS-Index wird nicht automatisch aktualisiert, wenn sich die Tabelle ändert; man baut ihn neu auf. Für lexikalische Suche über ein Korpus, das gelegentlich neu chunked wird, ist das in Ordnung; für ein Live-Inventar ist es nicht das richtige Werkzeug.
Vektorsuche nach Ähnlichkeit. Ehrlicher Stand, Stand v1.5: Es gibt keinen produktionsreifen ANN-Index im Core. Was existiert: Der fest dimensionierte ARRAY-Typ mit array_distance, array_cosine_similarity und Inner-Product-Funktionen — exakte Brute-Force-kNN in reinem SQL, was für Korpora bis zu einigen hunderttausend Vektoren oft genau das Richtige ist — sowie die experimentelle DuckDB Labs-Erweiterung, die HNSW-Indizes bereitstellt (CREATE INDEX ... USING HNSW (vec)), und eine Community-FAISS-Erweiterung mit GPU-Offload. Die Dokumentation ist erfreulich offen: HNSW-Persistenz ist experimentell und wird für den Produktionseinsatz nicht empfohlen. Die Forschungsfront ist aktiv: Die FlockMTL-Demo (VLDB 2025, arXiv:2504.01157) integriert LLMs und RAG tief als relationale Operatoren (llm_complete, llm_filter, llm_rerank mit MODEL- und PROMPT-Objekten), und die Vorschau auf v2.0 erwähnt approximate-nearest-neighbor-Joins direkt im SQL-Dialekt. vss Erweiterung, die HNSW-Indizes (CREATE INDEX ... USING HNSW (vec)) bereitstellt, sowie eine Community-FAISS-Erweiterung mit GPU-Offloading. Die Dokumentation ist erfreulich direkt: HNSW-Persistenz ist experimentell und wird für den Produktiveinsatz nicht empfohlen. Die Forschungsfront ist aktiv: Die FlockMTL-Demo (VLDB 2025, arXiv:2504.01157) integriert LLMs und RAG tiefgreifend als relationale Operatoren (llm_complete, llm_filter, llm_rerank mit MODEL- und PROMPT-Objekten), und die Vorschau auf v2.0 erwähnt approximative Nearest-Neighbor-Joins direkt im SQL-Dialekt.
Das Praktiker-Rezept für RAG, das sich in der MotherDuck-Engineering-Serie und DuckDBs eigenem Text-Analytics-Tutorial herauskristallisiert hat: Dokumente chunken, Embeddings erstellen (Hugging Face sentence-transformers lokal oder über eine gehostete API), Chunks und Vektoren in einer Tabelle speichern, mit SQL-Cosine-Similarity abrufen und — der wirklich clevere Teil — hybride Suche durchführen, indem BM25-Scores mit Embedding-Scores via Reciprocal Rank Fusion in einer einzigen Abfrage fusioniert werden. Kein Vector-Database-Deployment; die Retrieval-Schicht ist eine SQL-Abfrage gegen eine Parquet-Datei. Der Vollständigkeit halber: Genauso funktioniert auch die /knowledge-Suche dieser Website — anderes System, gleiche Philosophie.
Im Forschungsumfeld: Das Science Data Lake-Projekt (arXiv:2603.03126) baut wissenschaftliche Infrastruktur auf DuckDB und Parquet auf — 293 Millionen Papers, rund 960 GB, mit BGE-large-Embeddings für Ontologie-Alignment. Wenn jemand sagt, DuckDB sei „nur für Laptops“, ist das das Gegenbeispiel, das man parat haben sollte.
8. DuckDB für Geodaten: die leise PostGIS-Alternative
Geodaten sind der Bereich, in dem die Connector-Story wirklich überrascht, denn räumliche Daten waren lange DuckDBs schwächste Front — und dann, Release für Release, hörten sie auf, eine zu sein.
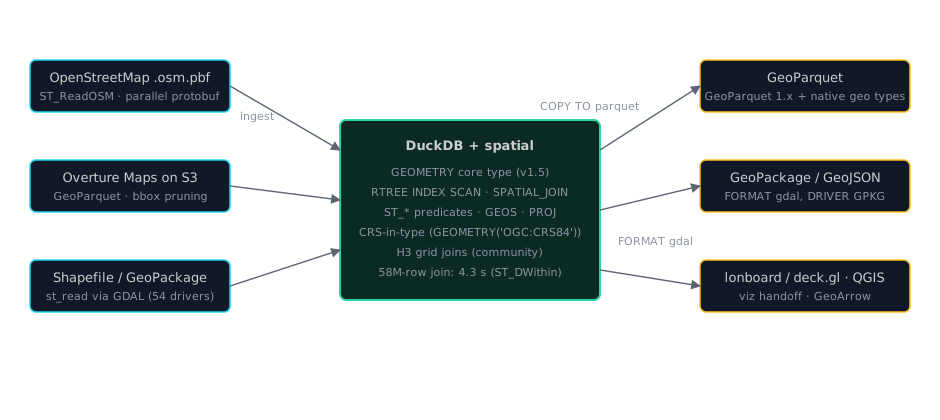
Das Typsystem bekam Koordinaten
Die spatial Erweiterung bündelt GDAL, GEOS und PROJ statisch — ohne Systemabhängigkeiten — und implementiert das OGC Simple Features-Modell: POINT bis GEOMETRYCOLLECTION, WKT-Literale in SQL, Z/M-Koordinaten sowie rund 150 ST_*-Funktionen, die Prädikate (ST_Intersects, ST_Contains, ST_Within…), Messungen, Überlagerungen, Vereinfachungen, Mapbox Vector Tiles (ST_AsMVT) und SVG-Ausgabe abdecken. Der entscheidende Schritt erfolgte in Version 1.5: GEOMETRY wurde zum Core-Engine-Typ (gespeichert als Standard-WKB, mit optionaler Spalten-„Zerkleinerung“, die einheitliche Geometriespalten dramatisch verkleinert), sodass Parquet, Iceberg, DuckLake, die Arrow/GeoArrow-Konvertierung und sogar der Postgres-Scanner Geometrien transportieren können, ohne die Spatial-Erweiterung zu laden. Auch Koordinatenreferenzsysteme hielten Einzug in das Typsystem — GEOMETRY('OGC:CRS84') ist nun eine Typannotation, mit über 7.000 registrierten EPSG-Codes und Konsistenzprüfung über Funktionsargumente hinweg.
Indizes und Joins: die überholte Einschränkung
In den ersten Jahren war DuckDB Spatials Achillesferse ehrlicherweise zu benennen: kein räumlicher Index. Das ist vorbei. Seit der Version-1.1-Ära (Ende 2024) gibt es einen echten R-Baum:
CREATE INDEX idx_zones USING RTREE (geom);
-- plan shows RTREE_INDEX_SCAN for constant-argument
-- ST_Intersects / ST_Within / ST_Contains / ... predicates
Und Version 1.3 (Mai 2025) fügte einen dedizierten SPATIAL_JOIN Operator hinzu, der zur Laufzeit einen ephemeren R-Baum auf dem kleineren Input aufbaut — kein manueller Index nötig. Der veröffentlichte Benchmark des Projekts (58 Millionen NYC-Taxifahrten × 310 Zonen, MacBook M3 Pro):
join strategy (58M rows)              runtime
blockwise nested loop                 1,799.6 s
bbox merge join (v1.2)                  107.6 s
SPATIAL_JOIN via ST_Intersects           28.7 s
SPATIAL_JOIN via native ST_DWithin        4.3 s
Ingest und Export: GDAL als universeller Spatial-Adapter
Das gebündelte GDAL stellt über 50 Vektortreiber bereit. Shapefiles, GeoPackages, GeoJSON, FlatGeobuf, KML, OpenFileGDB und mehr lassen sich via st_read abfragen — oder per Replacement-Scan, sodass FROM 'cities.gpkg' einfach funktioniert. OpenStreetMap erhält eine Sonderbehandlung: ST_ReadOSM parst komprimierte .osm.pbf-Dateien mit multithreaded Protobuf-Decoding (deutlich schneller als GDALs OSM-Treiber) und liefert Rohdaten von Nodes/Ways/Relations mit Tag-Maps, aus denen in SQL Geometrien erstellt werden können. Der Export ist symmetrisch: COPY (...) TO 'out.gpkg' (FORMAT GDAL, DRIVER GPKG). Beide Richtungen wurden in den Testläufen dieses Artikels verifiziert — inklusive eines GeoPackage-Schreib-Lese-Roundtrips und 54 tatsächlich vorhandener Treiber:
-- verified against DuckDB v1.5.5
SELECT ST_Distance_Sphere(ST_Point(16.3738, 48.2082),   -- Vienna
                          ST_Point(13.4050, 52.5200))   -- Berlin
 / 1000.0;                       -- -> 569 km (great-circle)

COPY (SELECT ST_Point(16.37, 48.21) AS geom, 'wien' AS name)
TO '/tmp/pt.gpkg' (FORMAT GDAL, DRIVER GPKG);
SELECT name FROM st_read('/tmp/pt.gpkg');      -- -> [('wien',)]
GeoParquet und der Overture-Workflow
DuckDB gehörte zu den ersten Engines mit durchgängiger GeoParquet -Unterstützung (Version 1.1, 2024), und die Integration vertieft sich weiter: GeoArrow-kodierte Spalten sowie seit Version 1.4 die nativen Parquet-GEOMETRY-Logical-Types — von DuckDB geschriebene Dateien sind gleichzeitig valides GeoParquet und natives Geometrie-Parquet, mit georäumlichen Statistiken pro Row-Group. Dies entspricht exakt der Ausrichtung von GeoParquet 2.0 (der Spezifikations-Release-Candidate für 2026 setzt erneut auf native Parquet-Geodatentypen). Der Flagship-Use-Case ist Overture Maps: DuckDB ist das offiziell dokumentierte Abfragewerkzeug von Overture, und das empfohlene Muster ist ein zweistufiger Prozess — bbox-vorgefilterte Parquet-Lesevorgänge direkt aus Overtures S3-Buckets (hive-partitioniert nach Thema/Typ, gefiltert nach der bbox-Abdeckung), gefolgt von einem regionalen Extrakt, der als lokales GeoParquet abgelegt wird:
SELECT geometry, names.primary AS name
FROM read_parquet('s3://overturemaps-us-west-2/release/2026-*/theme=buildings/*/*.parquet',
                  hive_partitioning = 1)
WHERE bbox.xmin BETWEEN 16.18 AND 16.58     -- Vienna bounding box
  AND bbox.ymin BETWEEN 48.10 AND 48.34
  AND ST_Intersects(
        geometry,
        ST_GeomFromText('POLYGON((16.18 48.10, 16.58 48.10,
                       16.58 48.34, 16.18 48.34, 16.18 48.10))'));

COPY (...) TO 'vienna_buildings.parquet';   -- local GeoParquet extract
H3: Hexagonale Raster aus der Community
Das hexagonale Rastersystem H3 von Uber ist als Community-Erweiterung verfügbar (gepflegt vom Autor der H3-Bindings, implementiert die vollständige H3-v4-API). Ein Detail, auf das ich selbst gestoßen bin: Sie steht nicht mehr im offiziellen Verzeichnis — die Installation erfolgt via INSTALL h3 FROM community. Der praktische Nutzen: teure räumliche Prädikate werden zu günstigen Hash-Equi-Joins; ein dokumentierter KNN-Fall reduzierte die Kandidatenpaare von 135 Milliarden auf 441 Millionen — eine dreihundertfache Verringerung — bei einer Abfrage, bei der DuckDB sonst den Speicher erschöpfte. Hier verifiziert:
INSTALL h3 FROM community;  LOAD h3;
SELECT h3_latlng_to_cell(48.2082, 16.3738, 7);       -- Vienna @ res 7
-- -> 608515207542603775
SELECT count(*) FROM (SELECT unnest(h3_grid_disk(
       h3_latlng_to_cell(48.2082, 16.3738, 7), 1)));
-- -> 7 (the cell + 6 neighbors)
SELECT count(*) FROM (SELECT unnest(h3_polygon_wkb_to_cells(
       ST_AsWKB(ST_GeomFromText('POLYGON((16.30 48.19, 16.45 48.19,
                    16.45 48.25, 16.30 48.19))')), 8)));
-- -> 52 hexagons cover that Vienna district
DuckDB Spatial oder PostGIS?
Die Community-Benchmarks (die genau das sind — von der Community durchgeführt, mit einer dokumentierten Methodendiskussion zu Ladeformaten, daher als Richtwerte zu verstehen) zeichnen ein konsistentes Bild: Bei Parquet-basierten analytischen Workloads — Punkt-in-Polygon-Zählungen, Distanz-Joins, flächengewichtete Interpolationen — hält DuckDB mit PostGIS mit oder übertrifft es, oft um erhebliche Faktoren. PostGIS behält die umfassendste Funktionsabdeckung (Topologie, Raster, native KNN mit dem <->-Operator) und bleibt die richtige Wahl für räumliche Mehrbenutzer-Transaktionsdatenbanken. QGIS-Workflows lassen sich sauber über GeoPackage oder GeoParquet verknüpfen. Es gibt sogar einen Korrektheits-Datenpunkt: Die Spatter-Fuzzing-Studie (arXiv:2410.12496) testete DuckDB Spatial gegen PostGIS, MySQL und SQL Server und ordnete es in dieselbe Liga ein — inklusive 34 bisher unbekannter Logikfehler in allen vier Engines, von denen die meisten inzwischen behoben wurden. Die ehrliche Zusammenfassung: PostGIS ist die Produktions-Spatial-Datenbank; DuckDB ist die Produktions-Spatial-Analytics-Engine — und für dateibasierte, Single-Node-analytische Arbeit ist es die Rolle, die bisher fehlte.
9. Ein Arbeitstag mit DuckDB: ein verifiziertes Skript
Um den Kreis zu schließen, hier die gesamte Konnektivitätsthese komprimiert in einer realistischen Pipeline — jede der folgenden Aussagen wurde während der Entstehung dieses Artikels gegen v1.5.5 ausgeführt:
-- 1. live operational database
ATTACH 'dbname=airdata user=postgres host=127.0.0.1 port=55432'
       AS pg (TYPE POSTGRES);

-- 2. land a copy as partitioned Parquet (the new cold storage)
COPY (SELECT id, city, pm25, recorded_at FROM pg.public.sensors)
TO 'sensors' (FORMAT PARQUET, PARTITION_BY (city));

-- 3. join it with an in-memory DataFrame (Arrow, zero-copy)
SELECT p.city, avg(p.pm25 + d.noise) AS adjusted
FROM read_parquet('sensors/*/*.parquet', hive_partitioning = 1) p
JOIN df d ON d.id = p.id
GROUP BY p.city;

-- 4. search the result corpus lexically
PRAGMA create_fts_index('docs', 'id', 'title', 'body');

-- 5. ship geometries to GIS colleagues
COPY (SELECT city, ST_Point(lon, lat) AS geom FROM stations)
TO 'stations.gpkg' (FORMAT GDAL, DRIVER GPKG);

-- 6. detach, done. No server was harmed.
DETACH pg;
Der moderne Datenstack in einer Box: extrahieren, ablegen, transformieren, suchen, kartieren — fünf Befehle, null Server, ein formatagnostischer Motor.
10. Wo DuckDB keine Lösung ist
Ein erschöpfender Artikel schuldet Ihnen die Fehlermodi. Vier stechen hervor:
- OLTP. Viele gleichzeitige kleine Lese-Schreib-Transaktionen sind das, wofür Postgres und SQLite gemacht sind. DuckDB ist analytisch konzipiert; sein MVCC ist auf Bulk-Operationen optimiert, nicht auf Punkttransaktionen.
- Mehrfach-Schreibkonkurrenz. Ein Schreibprozess pro Datenbankdatei; eine einzelne Transaktion schreibt in eine einzelne angehängte Datenbank. Die beiden Ausweichmöglichkeiten — DuckLake mit einem PostgreSQL-Katalog und das v2.0-Quack-Serverprotokoll — sind präzise darauf ausgelegte Lösungen, aber sie sind Erweiterungen, nicht das Basismodell.
- Vektorsuche im großen Maßstab. Brute-Force-kNN in SQL ist real und oft ausreichend; die HNSW-Erweiterung ist explizit experimentell mit standardmäßigem In-Memory-Persistenzmodell. Ab einigen hunderttausend Vektoren oder strengen Latenz-SLOs verdienen dedizierte Vektorspeicher weiterhin ihre Berechtigung.
- Raster-Geodaten und Streaming-Integration. Keine Raster-Unterstützung in der Kern-Spatial-Erweiterung (Community-Erweiterungen für GeoTIFF/COG schließen Lücken), keine Change-Data-Capture-Lösung, und der FTS-Index muss manuell neu aufgebaut werden. Machen Sie sich damit vertraut, bevor sie es tun.
Adoption — kurz gefasst
Die Verbreitung verläuft ungewöhnlich für Infrastruktursoftware: 40.000 GitHub-Sterne (August 2026), über 50 Millionen PyPI-Downloads pro Monat, ein Aufstieg in der DB-Engines-Rangliste unter die Top 50 und die erste Nutzerumfrage des Projekts (2024), die wie ein Porträt des analytischen Long Tail wirkt — drei Viertel der Nutzer:innen verarbeiten Datensätze unter 100 GB, 87 % laufen auf Laptops, Parquet und CSV sind die dominierenden Formate. MotherDuck vermarktet den Hybrid-Cloud-Ansatz; Crunchy Data integrierte den Motor in Postgres für ihr Analyseprodukt; von Google, Meta und Airbnb wurde die Nutzung berichtet (via The Register — Sekundärquelle, entsprechend einordnen); Spotify hat öffentlich über SQL-Abfragen auf Hörverläufen gesprochen. Und das Governance-Modell — eine niederländische Non-Profit-Organisation, die das MIT-lizenzierte geistige Eigentum auf Dauer hält, ohne Enterprise-Edition — ist selbst eine These darüber, was Infrastruktur sein sollte.
Coda: Der Connector ist die Datenbank
Tritt man einen Schritt zurück, bleibt eine zentrale Designidee: DuckDB hat den query engine von Ort und Format der Daten entkoppelt — und die Kopplung anschließend kostengünstig auf SQL-Ebene wiederhergestellt. Postgres bleibt das System of Record; S3 bleibt der Data Lake; der GIS-Ordner behält seine QGIS-Form; das Notebook bleibt ein Notebook. Keines davon muss erst zur Datenbank werden, damit analytische Fragen beantwortet werden können. Das ist nicht einfach ein Werkzeug, das eine Kategorie gewinnt. Das ist eine Kategorie — die ETL-Pipeline als zwingender Mittelsmann — die leise schrumpft.
Jede der oben genannten Aussagen lässt sich auf eine Primärquelle zurückführen, und jeder Codeblock wurde vor der Veröffentlichung ausgeführt. Wenn Sie sich nur eines merken: Führen Sie pip install duckdbaus, öffnen Sie eine Python-REPL und richten Sie sie auf das heterogene Durcheinander, das Sie gerade herumliegen haben. Der Motor erledigt den Rest.
Quellen
- Why DuckDB — https://duckdb.org/why_duckdb
- Raasveldt & Mühleisen, DuckDB: an Embeddable Analytical Database (SIGMOD 2019 demo) — DOI 10.1145/3299869.3320212 · https://duckdb.org/library/duckdb-sigmod-demo/
- Raasveldt & Mühleisen, Data Management for Data Science — Towards Embedded Analytics (CIDR 2020) — https://hannes.muehleisen.org/publications/CIDR2020-raasveldt-muehleisen-duckdb.pdf
- Kohn et al., DuckDB-Wasm: Fast Analytical Processing for the Web (PVLDB 15(12), 2022) — DOI 10.14778/3554821.3554847
- Atwal et al., MotherDuck: DuckDB in the Cloud and in the Client (CIDR 2024) — https://www.cidrdb.org/cidr2024/papers/p46-atwal.pdf
- Internals: Vektorformat — https://duckdb.org/docs/current/internals/vector.html · Storage — https://duckdb.org/docs/current/internals/storage.html
- Concurrency-Modell — https://duckdb.org/docs/current/connect/concurrency.html
- ATTACH-Anweisung — https://duckdb.org/docs/current/sql/statements/attach.html
- PostgreSQL-/MySQL-/SQLite-Erweiterungen — https://duckdb.org/docs/current/core_extensions/postgres/overview.html · …/mysql.html · …/sqlite.html
- Parquet — https://duckdb.org/docs/current/data/parquet/overview.html · CSV-Autoerkennung — https://duckdb.org/docs/current/data/csv/auto_detection.html
- Hive-Partitionierung — https://duckdb.org/docs/current/data/partitioning/hive_partitioning.html · mehrere Dateien — https://duckdb.org/docs/current/data/multiple_files/overview.html
- httpfs / S3-API — https://duckdb.org/docs/current/core_extensions/httpfs/s3api.html · Secrets Manager — https://duckdb.org/docs/current/sql/statements/create_secret.html
- Hugging Face — https://duckdb.org/2024/05/29/access-150k-plus-datasets-from-hugging-face-with-duckdb.html
- Lakehouse-Formate — https://duckdb.org/docs/current/lakehouse_formats.html · Iceberg-Writes — https://duckdb.org/2025/11/28/iceberg-writes-in-duckdb.html · DuckLake — https://duckdb.org/docs/current/core_extensions/ducklake.html
- DuckDB × Arrow (Zero-Copy) — https://duckdb.org/2021/12/03/duck-arrow.html · PyTorch-Guide — https://duckdb.org/docs/current/guides/python/pytorch.html
- JupySQL — https://duckdb.org/2023/02/24/jupysql.html · marimo — https://duckdb.org/docs/current/guides/python/marimo.html
- Volltextsuche — https://duckdb.org/2021/01/25/full-text-search.html · Dokumentation — https://duckdb.org/docs/current/core_extensions/full_text_search.html
- Vektorsimilarität / vss — https://duckdb.org/2024/05/03/vector-similarity-search-vss.html · https://duckdb.org/docs/current/core_extensions/vss.html
- MotherDuck-Suchreihe (Vektor, RAG, hybrides RRF) — https://motherduck.com/blog/search-using-duckdb-part-1/ (und Teile 2–3)
- FlockMTL: Deep Integration of LLMs and RAG into DuckDB (VLDB 2025 Demo) — arXiv:2504.01157
- The Science Data Lake — arXiv:2603.03126 · Text-Analytics-Walkthrough — https://duckdb.org/2025/06/13/text-analytics.html
- Spatial-Erweiterung — https://duckdb.org/docs/current/core_extensions/spatial/overview · Funktionen — …/spatial/functions · R-Baum — …/spatial/r-tree_indexes
- Spatial Joins + Benchmarks — https://duckdb.org/2025/08/08/spatial-joins · GEOMETRY-Kerntyp — https://duckdb.org/2026/03/09/announcing-duckdb-150
- GDAL-Integration — https://duckdb.org/docs/current/core_extensions/spatial/gdal · Overture + DuckDB — https://docs.overturemaps.org/getting-data/duckdb/
- GeoParquet — https://geoparquet.org/ · H3-Community-Erweiterung — https://duckdb.org/community_extensions/extensions/h3 · https://github.com/isaacbrodsky/h3-duckdb
- Spatter-Spatial-SQL-Fuzzing-Studie — arXiv:2410.12496 · Community-Benchmarks: forrest.nyc SedonaDB/DuckDB/PostGIS-Vergleich; bench_geo_db (pierre-warnier)
- Releases — v1.4.0 LTS: https://duckdb.org/2025/09/16/announcing-duckdb-140.html · v1.5.0: https://duckdb.org/2026/03/09/announcing-duckdb-150.html · v2.0-Vorschau: https://duckdb.org/2026/08/17/duckdb-20-highlights.html
- Adoption — 40.000 Sterne: https://duckdb.org/2026/08/05/github-40k-stars.html · Nutzerumfrage: https://duckdb.org/2024/10/04/duckdb-user-survey-analysis.html · DuckLabs schließt sich AWS an: https://duckdb.org/2026/08/26/ducklabs-to-join-aws.html
- Modern Data Stack in a Box — https://duckdb.org/2022/10/12/modern-data-stack-in-a-box.html · Crunchy Data — https://www.crunchydata.com/blog/how-we-fused-duckdb-into-postgres-with-crunchy-bridge-for-analytics
- The Register über DuckDB-Adoption (Oktober 2023) — https://www.theregister.com/2023/10/05/duckdb_labs_puts_limit_on_vc_funds/
weiterlesen
n8n treibt die Hälfte aller Automatisierungen im Internet an. Nennen Sie es einfach nicht Open Source.
Zwei Lager beherrschen den Bau von Agenten – entweder alles dem Modell überlassen oder jeden Pfad manuell routen. n8n besetzt die Mitte: eine Fair-Code-Leinwand mit 2.273 Integrationen, LangChain-gestützten Agenten, Preisen pro Ausführung und einer Produktions-Ops-Geschichte, die die meisten Berichte auslassen. Jede hier genannte Zahl stammt aus einer Primärquelle.
technik · 15 min · 2026-09-27
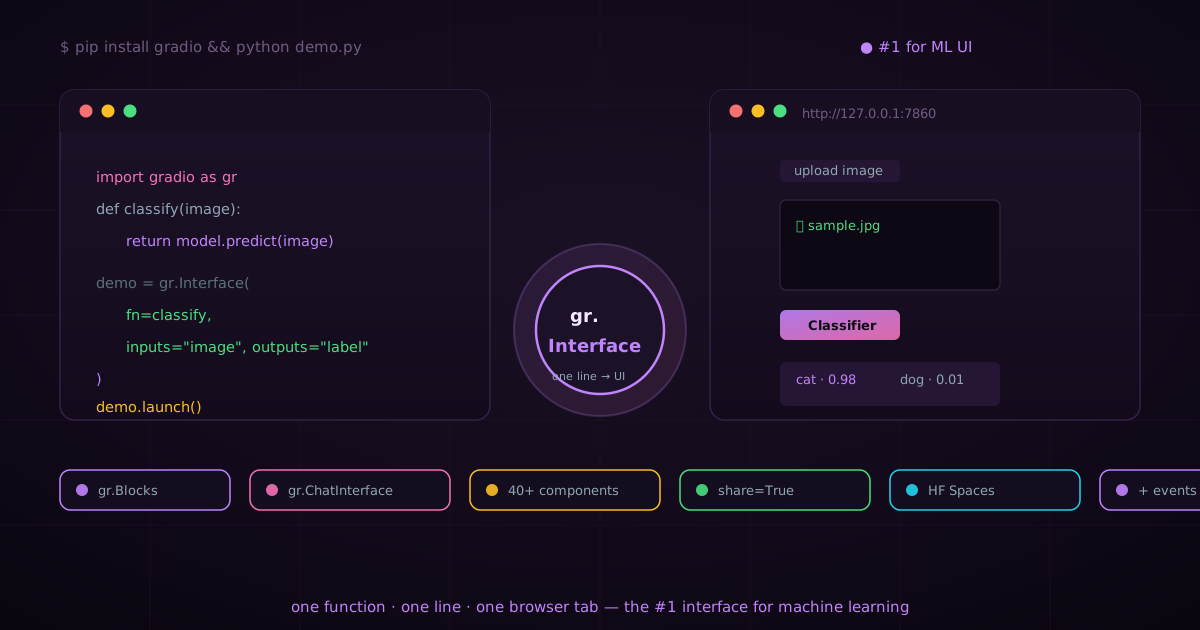
Gradio: die Nummer-eins-Schnittstelle für Machine Learning — eine Codezeile zwischen Modell und Welt
Ein Modell, das niemand nutzen kann, ist nur eine Belastung. Gradio ist die Schnittstellenebene, die Machine Learning nutzbar gemacht hat: packen Sie jede Python-Funktion mit einer Codezeile in eine Browser-UI – vom einfachen gr.Interface bis zu mehrseitigen Blocks-Apps und ChatInterface-LLM-Frontends. Dann teilen Sie es per öffentlicher URL oder stellen es auf Hugging Face Spaces bereit, der Heimat von ML-Demos. Entwickelt von Abubakar Abid an der Stanford University und betreut von Hugging Face, ist Gradio zum Standard geworden, wie die Welt KI berührt. Das ist die vollständige Übersicht.
technik · 17 min · 2026-09-13
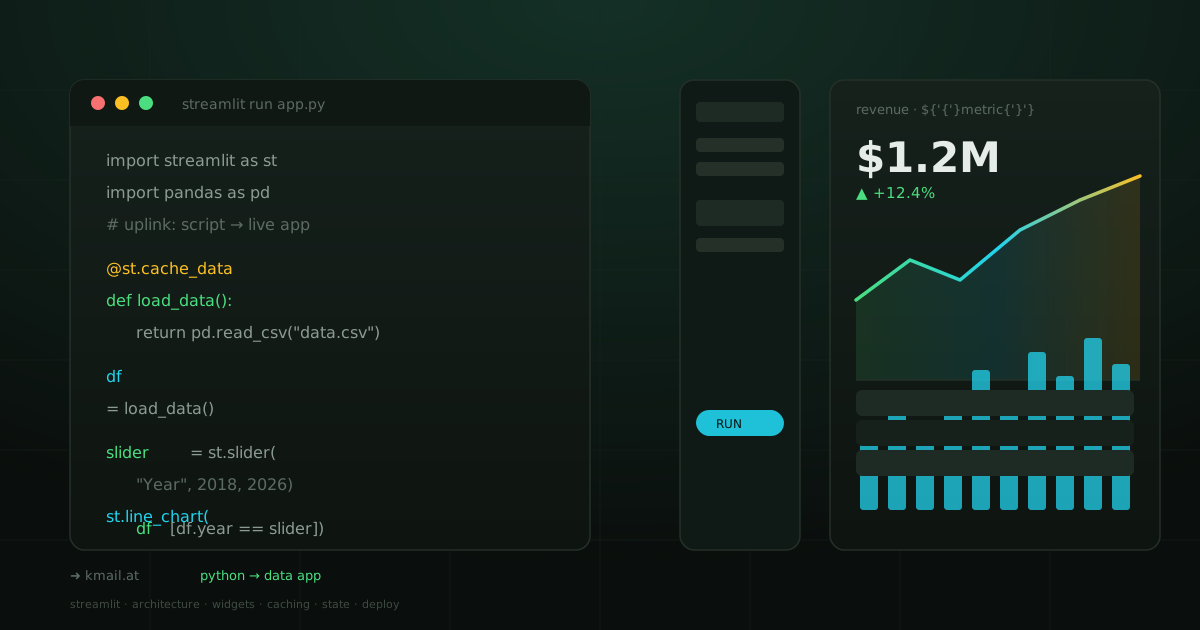
Streamlit: der schnellste Weg von einem Python-Skript zur fertigen Daten-App
Streamlit verwandelt einfache Python-Skripte in interaktive Web-Apps, ohne eine Zeile HTML, CSS oder JavaScript schreiben zu müssen. Hier der vollständige Überblick: wie die Rerun-Architektur funktioniert, alle Widget-Typen, Caching und Session-State, Multi-Page-Apps, Custom Components, Theming, Deployment, Sicherheit und wie es sich gegen Dash, Gradio und Panel behauptet.
technik · 18 min · 2026-09-13